讓 Jev 幫我打一局德州撲克
Jev 一個字都不生成。不能聊天,不能寫程式,只回傳帶有型別的判斷和一個校準過的機率。我把一手真實牌局的翻牌圈提供給它,只問一個決策點:第一遍它建議跟注,自己只有 32% 的把握;我在局面描述裡補了一句話,它翻轉成棄牌,把握提高到 63%,而棄牌才是數學上正確的答案。那句話是「我手裡沒有方塊」。這篇講的是它為什麼推不出來,以及為什麼這比結論更值得記住。
Jev 是什麼
2026 年 9 月 15 日,一家叫 TypeSafe AI 的公司發布了第一個模型 Jev。創辦人 Diogo Almeida 是前 OpenAI 研究員、RLHF 的共同發明人之一,也就是 ChatGPT 背後那套方法的作者之一。
他們給 Jev 的定位叫 System One Model,對應卡尼曼那套「系統一是快速直覺判斷,系統二是慢速推理」。
它和你熟悉的所有大型模型,有一個根本差別:
它完全不生成文字。
不能聊天,不能寫程式,一個字都吐不出來。你給它一段材料和一組帶有型別的問題,它回傳帶有型別的答案:一個選擇、一個分數、一個機率,每個都附帶信心度。
和大型模型的四個差別
一、架構上不解碼。 大型模型是逐個 token 往外吐,結構化輸出是把吐出來的字串再解析成 JSON。Jev 沒有語言模型頭,直接用決策頭輸出機率分布,中間沒有「先寫一段話再轉成結構」這一步。
二、答案空間由你定義。 你給它三個選項,它只能在這三個裡選。「輸出了一個不存在的分類」在架構上就不可能發生,這不是靠提示詞約束,是靠結構。
三、機率是校準過的。 這是最值錢的一點,也是它整個訓練方法的目標。TypeSafe 把這套訓練叫作 RLCD(Reinforcement Learning for Calibrated Decisions):不用人類偏好評分,而是用可驗證的真實答案,搭配嚴格評分規則計算獎勵。目標不是「讓人覺得好」,而是「說 70% 的時候,真的就該有 70% 會中」。
四、便宜又快。 輸入 $0.042 / 百萬 token,輸出免費,因為它根本不產出 token。延遲大約是幾十到幾百毫秒。
為什麼「校準」是重點
我在本機做過一個對照。用 Ollama 跑本機模型,把候選對應成字母,直接讀取 token 的 logprob,再正規化,這樣拿到的是模型真正的輸出分布,不是問它「你有多確定」。
然後問它一個原理上無法知道答案的問題:
一枚硬幣已經擲出但尚未揭曉,是正面嗎?
本機模型給的是 99.9%。溫度調到 0、1、2 都一樣,因為那是未經溫度縮放的原始分布。
同樣的問題給 Jev:51%。
差別不在於誰更聰明。本機那個模型當然知道硬幣是一半一半,你在聊天裡問它,它會告訴你 50%。缺的不是知識,是那個數字沒有承載知識。 被迫選一個 token 的時候,它就是會給 99.9%。
RLCD 教的不是「硬幣是公平的」,是讓那個數字有意義。
註冊
好消息:TypeSafe 在 9 月 21 日取消了候補名單,現在 console.typesafe.ai 直接註冊就能用,新帳號送 $5 額度,依 $0.042 / 百萬 token 計算,大約一億兩千萬 token。玩起來基本上等於無限。
注意是 console 子網域,主站 typesafe.ai 是產品頁。API Key、Playground、用量面板都在 console 裡。
Playground 長這樣:左上填 State,左下寫 Questions(JSON),右邊顯示結果。
把一手牌翻譯成 State 和 Questions
拿來做實驗的是一場直播現金桌裡的一手牌。先說清楚範圍:我沒有讓它打完一局,只截取了翻牌圈的一個決策點,問它此刻該棄牌、跟注還是加注。
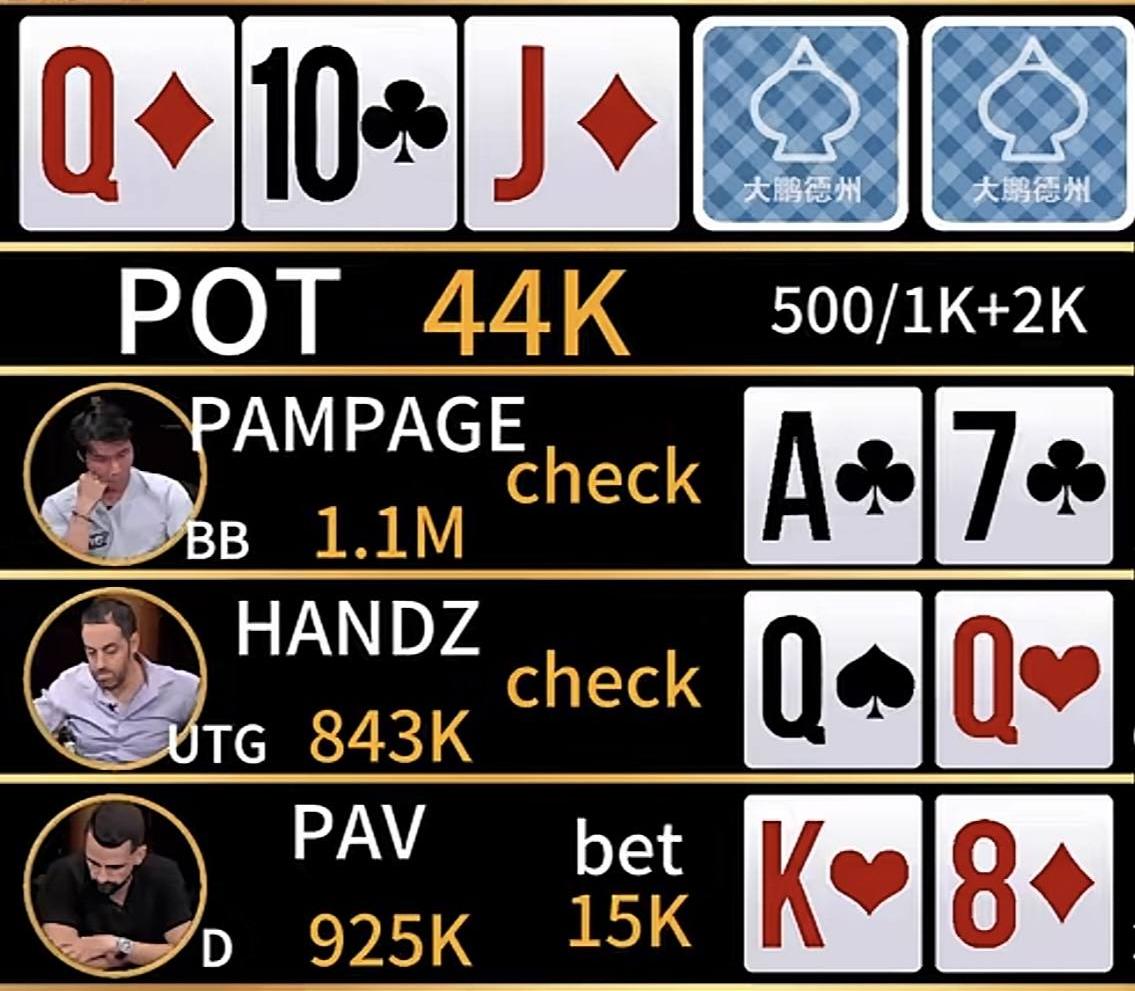
翻牌 Q♦ 10♣ J♦,底池 29,000。三個人:PAMPAGE 在大盲位拿 A♣7♣,HANDZ 在槍口位拿 QQ,PAV 在按鈕位拿 K8。
我要做的是:站在 PAMPAGE 的位置上,讓 Jev 給一個決策。
第一個設計決定:不能給它上帝視角
直播畫面是上帝視角:三家的底牌全亮著,HANDZ 的 QQ、PAV 的 K8 都一目了然。這些絕對不能進 State。
因為 PAMPAGE 坐在牌桌上時,看不見對手的牌。放進去會得到一個「正確但毫無用處」的建議,它是在用上帝視角做決策,而真實情境裡你沒有那份資訊。
這是設計這類系統最容易犯的錯:State 裡只能有決策者當下真的能觀察到的東西。
第二個設計決定:能算的別問
跟注賠率是確定的算術:
下注前底池 29,000 + 按鈕位下注 15,000 + 我跟注 15,000 = 59,000
15,000 ÷ 59,000 = 25.4%
意思是我至少要有 25.4% 的勝率,這次跟注才不虧。這個數字我用計算機算好,寫進 State,不問模型。 模型該做的是判斷,不是計算。
最後的 State
Six-handed cash game. Blinds are 500/1000 with a 2000 ante from every player.

I am in the big blind holding A♣ 7♣ (the ace and seven of clubs).
The flop is Q♦ 10♣ J♦ (queen of diamonds, ten of clubs, jack of diamonds).

Preflop: the UTG player raised to 5,500, the button called, I called from the
big blind, and the small blind folded. Three players saw the flop and the pot
was 29,000.

Flop action so far: I checked, the UTG player checked, and the button bet
15,000.

It is now my turn. Calling costs 15,000. If I call, the pot will be 59,000,
so I am getting 25.4% pot odds.

The UTG player still acts after me, so calling does not close the action and
I could still face a raise.

Stacks: me 1,100,000, the UTG player 843,000, the button 940,000.

I have no diamonds in my hand, so I have no flush draw. My only draw is a
gutshot to Broadway, needing a king.
最後那兩句是這次實驗的關鍵,後面再說。
Questions:三種類型,分四層
Jev 有三種問題類型:
| 類型 | 答案空間 | 回傳 |
|---|---|---|
| Noul | 固定:真 / 假 | 一個機率 |
| Choice | 你定義的選項 | 每個選項一個機率 + 總信心度 |
| Score | 你定義的等級 | 一個數值(可以是小數)+ 信心度 |
criteria 就是你定義答案空間的地方。Choice 用物件,鍵是選項;Score 用陣列,索引就是分數。Noul 沒有 criteria,因為答案空間本來就固定,沒什麼可定義的。
我把六個問題拆成四層:
{
  "currently_best_hand": {
    "type": "noul",
    "instructions": "Right now on this flop, is my hand most likely the best hand among the players still in the pot?"
  },
  "made_hand_strength": {
    "type": "score",
    "instructions": "How strong is my made hand right now, ignoring any drawing potential?",
    "criteria": [
      "No pair and no showdown value at all",
      "High card only, or bottom pair",
      "Middle pair, or a weak top pair",
      "Strong top pair",
      "Two pair or better"
    ]
  },
  "draw_quality": {
    "type": "score",
    "instructions": "How good is my potential to improve to a winning hand on the turn or river?",
    "criteria": [
      "No draw at all",
      "Gutshot straight draw only, roughly four outs",
      "Open-ended straight draw, or a flush draw",
      "Strong combination draw with many outs",
      "Drawing to the effective nuts with a very large number of outs"
    ]
  },
  "opponent_range_is_strong": {
    "type": "noul",
    "instructions": "Given the preflop action and this flop, does the betting player's range look strong here?"
  },
  "utg_likely_to_raise": {
    "type": "noul",
    "instructions": "If I call the 15,000, is the UTG player behind me likely to raise?"
  },
  "action": {
    "type": "choice",
    "instructions": "Facing a 15,000 bet with one player still to act behind me, what should I do?",
    "criteria": { "Fold": null, "Call 15,000": null, "Raise": null }
  }
}
為什麼不直接問一句「我該怎麼打」?
因為那樣你只會得到一個答案和一個信心度,完全不知道模型在哪一步出錯。拆開之後,每個環節都能單獨驗證,而這正是後來救了我的東西。
前兩個問題尤其重要:它們的正確答案我已經知道,所以可以用來檢驗模型到底有沒有讀懂牌面。先用已知答案的問題驗證,再去相信那些你不知道答案的問題。
Jev 的回答
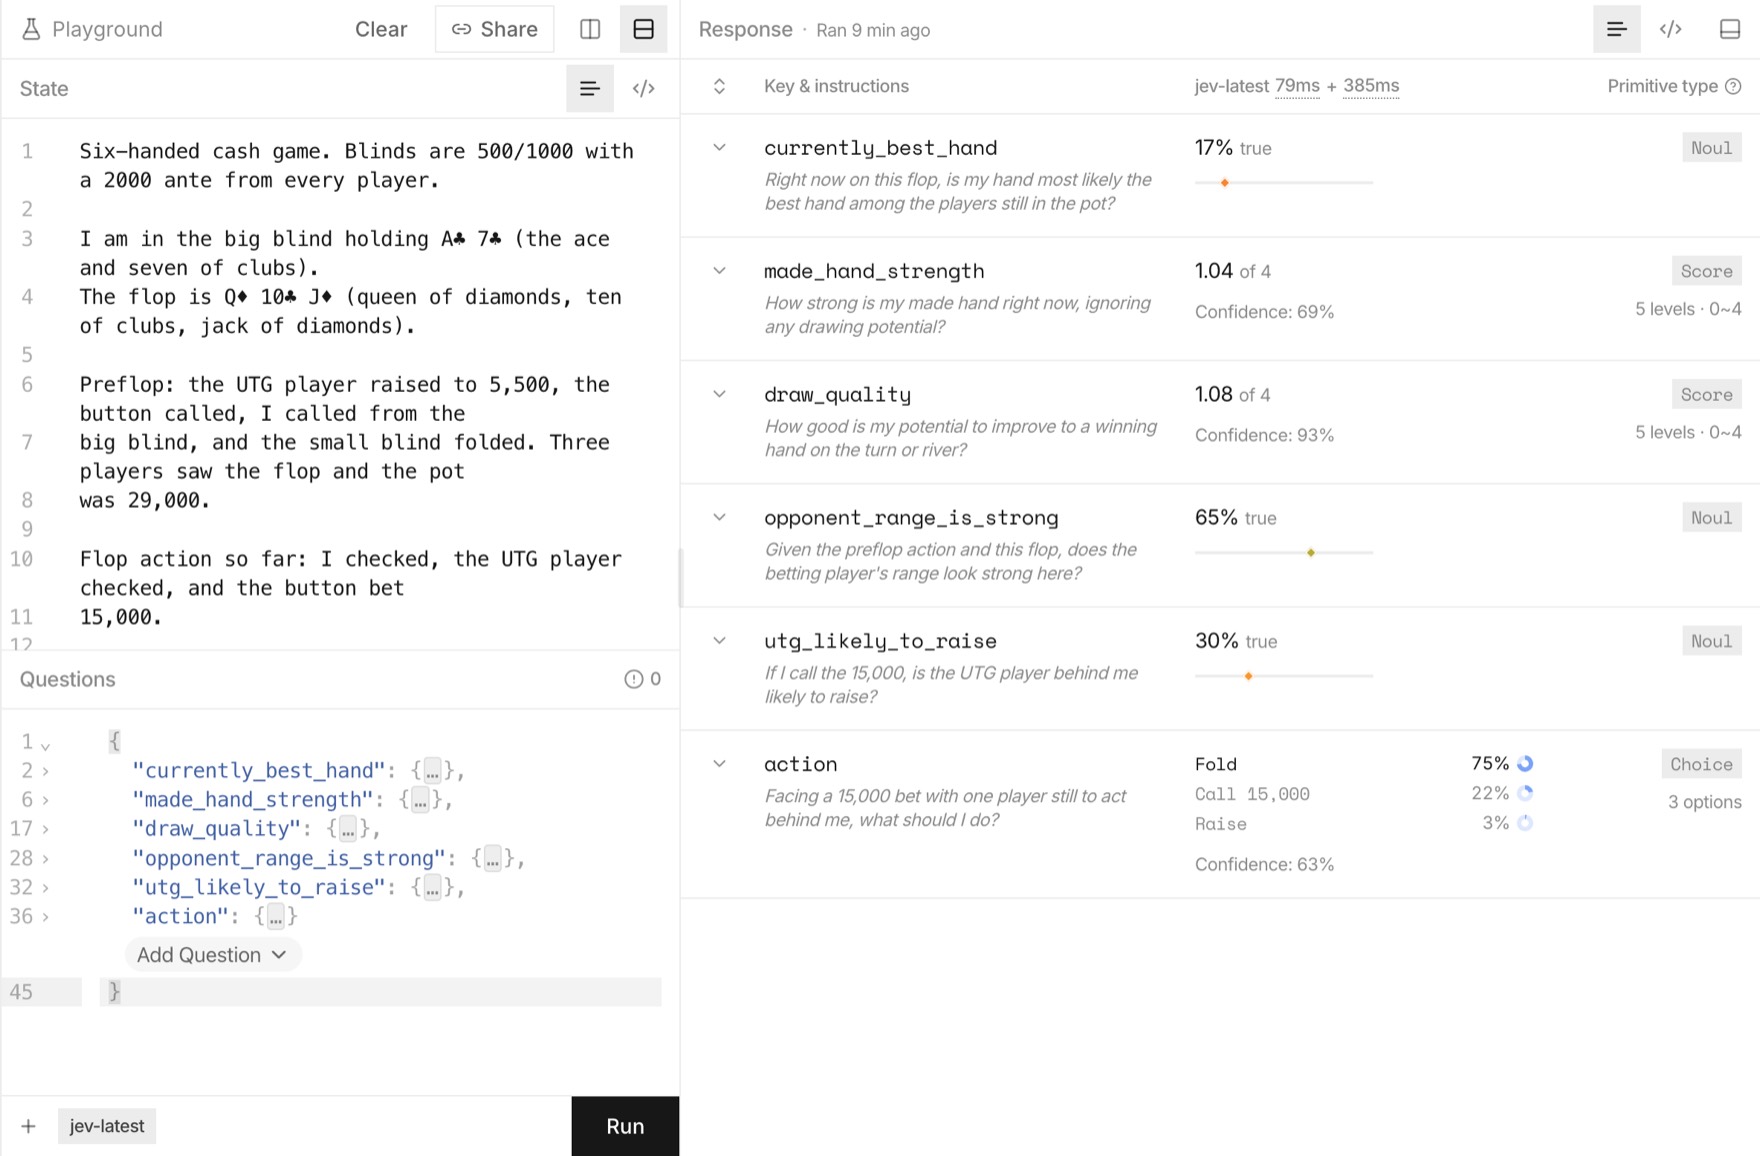
| 問題 | 回答 | 信心度 |
|---|---|---|
| 我現在是最大的嗎 | 17% 為真 | — |
| 成牌強度 | 1.04 / 4 | 69% |
| 聽牌品質 | 1.08 / 4 | 93% |
| 對手範圍強嗎 | 65% 為真 | — |
| 後面的人會加注嗎 | 30% 為真 | — |
| 我該怎麼打 | 棄牌 75% / 跟注 22% / 加注 3% | 63% |
逐一解讀
我現在是最大的嗎 → 17%。只有 A 高牌,沒成對。牌面 Q-J-10,對手手裡只要有 Q、J、10 中任何一張,就成對了。要贏,必須兩家都沒中牌,高牌還都比我小。17% 甚至有點樂觀。
成牌強度 → 1.04 / 4。落在第 1 級「只有高牌」。沒落到第 0 級(毫無攤牌價值),是因為 A 高終究還能贏對方的 K 高、Q 高。回傳 1.04 而不是整數,是因為它給的是整個分布的期望值。
聽牌品質 → 1.08 / 4,信心度 93%。落在第 1 級「只有卡順,約四張補牌」,完全正確。我的 A 配上牌面的 Q-J-10,只差一張 K 就成 A-K-Q-J-10,整副牌有四張 K。牌面那兩張方塊在公共牌上,不在我手裡,所以沒有同花聽牌。93% 是整個畫面最高的信心度。這一項是整篇文章的轉折點。
對手範圍強嗎 → 65%。按鈕位在兩家都過牌後才下注。要嘛真的有牌,要嘛看兩家示弱,想偷底池。65% 偏向「真的有牌」,留三成多給詐唬,分配合理。
後面的人會加注嗎 → 30%。UTG 翻牌前加注,翻牌後卻過牌了,過牌這個動作通常會弱化範圍。但過牌加注是確實存在的打法,所以不能給 0。
這裡有個值得玩味的地方:實際上 HANDZ 手裡是 QQ,在這個牌面上是三條,他很可能真的會加注。 但 Jev 不該知道,PAMPAGE 在牌桌上看不見。從那個座位能拿到的資訊看,30% 就是誠實的答案。這正是一開始堅持不洩漏底牌的意義。
我該怎麼打 → 棄牌 75% / 跟注 22% / 加注 3%,信心度 63%。棄牌為什麼對:
需要的勝率        25.4%
卡順,下一張牌     4 ÷ 47 = 8.5%
就算能看兩張牌     ≈ 16.5%
而且 UTG 在我後面,這 15,000 不能保證買到兩張牌,連 16.5% 都拿不到。
跟注那 22% 不是雜訊,它對應的是隱含賠率:萬一真的來了 K,對手會付給我一個大底池。Jev 認為這個理由存在,只是判斷它不夠補上缺口。
加注 3%:對著一個有 65% 機率偏強的範圍詐唬,後面還有人可能再加注,幾乎永遠是錯的。約等於零,判斷準確。
一個結構上的細節
你會注意到,Noul 那三個問題沒有單獨的信心度,而 Choice 和 Score 有。
因為對是非題來說,機率本身就是答案,「17% 為真」已經把不確定性說完了。而 Choice 和 Score 的答案是「選了哪個」「落在哪一級」,這個選擇本身有多可靠是另一個問題,所以需要額外一個數字。
真正的發現
前面跳過的那件事:第一次跑的時候,State 裡沒有最後那兩句。
它把牌面上的兩張方塊,當成了我的同花聽牌。
這個推理對人來說是零成本的:我拿 A♣7♣,牌面 Q♦J♦,一眼就知道我沒方塊。但它做不了這個減法。補上一句「我手裡沒有方塊」,聽牌評估立刻落到正確等級,信心度從整個畫面最低變成最高,最終建議也跟著翻轉了。
只看我給的 State,Jev 能不能推斷哪些牌屬於誰?
答案是不能。所以:
凡是「X 屬於 A,不屬於 B」這類歸屬關係,必須明確寫進 State,不要指望模型自己推。
三個可以重複運用的心得
一、錯誤傳播鏈是看得見的。 它之前建議跟注,唯一原因就是高估了聽牌。上游一修正,下游立刻反轉。如果我只問一句「我該怎麼打」,就看不到這條鏈,只會覺得模型反覆無常。
二、信心度精確指出了 bug 的位置。 第一次跑的時候,39% 是整個畫面最低,正是出錯的那個環節。依信心度由低到高排序,修正最低的那個,重新跑。 這是一套可以直接拿去用的排查流程,不需要懂撲克。
三、信心度是誠實的。 它錯的時候說自己沒把握,對的時候說自己有把握,兩次都說對了。這就是校準的全部意義,也是本機那個玩具永遠做不到的事,它在兩種情況下都會給你 100%。
最後
Jev 不是撲克求解器,別指望它取代 solver。GTO solver 給的是數學上可證明的最佳解,Jev 給的是判斷,這是兩件事。
它也不是「最終答案」,而是一個元件。這個局面真正的結論,來自三樣東西的匯合:確定的算術(需要 25.4%,實際 8.5%)、模型的判斷(棄牌 75%)、位置的事實(跟注不能封頂)。三者指向同一個方向,才是該行動的時候。
反過來說:如果模型說跟注,算術卻說會虧,聽算術的。算術是確定的,模型是判斷,這個優先順序不能顛倒。
還有一句和牌桌無關的:我們不知道這手牌實際怎麼走,截圖只到翻牌。但即使跟注後真的來了一張 K、贏下一個大底池,棄牌仍然是當時正確的決策。8.5% 的事情會發生,發生了也不代表當初該跟注。
結果好,不等於決策對。