我用 Claude、Codex 和 Seedance 做了一支 AI 短片
我照著一則推文裡的 AI 影片工作流程,完整做了一支 75 秒的超寫實短片:Claude 當導演,Codex 畫首尾影格,Seedance 生成影片。15 個鏡頭全部一次生成成功,零重拍,影片生成總共花了約 12 美元。但看完成片,我自己的評價是:像一個不斷翻頁的 PPT。
這次嘗試完全基於 @EianLu 公開分享的工作流程,感謝他把整套方法和提示詞都寫出來。
這篇依時間順序記錄整個過程:每一輪審查挑出了什麼、生成前擋下哪些錯誤、真正踩到的坑,以及我自己對「為什麼不好看」的反思。
先說結果
- 「把錯誤擋在花錢之前」真的有效。15 個鏡頭零重拍。死人睜著眼、1976 年的日本人用普通話喊叫、憑空出現的一隻手,全都在生成之前被擋下。
- 最大的坑:Seedance 拒絕寫實人臉。原文沒有提到這個限制:它把寫實列為可選的畫風之一,但提示詞範例和配圖都是手繪風格。直接套到寫實人物上,有臉的鏡頭只能換 Kling。
- 但成片不好看。我的審查一直在把片子改得更清楚、更合理、更容易拍,回頭看,也把它改得越來越平淡。
原方法一句話版
方法來自 @EianLu 的推特長文:Claude 當導演,負責寫故事、分鏡、提示詞、審查和後製程式碼;Codex 當繪師,畫設定圖和每個鏡頭的首尾影格;Seedance 當動畫師,把首尾影格變成幾秒的影片。
它的核心原則是把錯誤擋在花錢之前:文字裡能發現的錯,不留到圖上;圖上能發現的錯,不留到影片上。每一步都另外開一個審查 agent,讓它在沒有任何上下文的情況下重新看一遍。
我想驗證的只有一件事:照著做,是不是真的像他說的那麼好用。
題材:木內鶴彥的 30 分鐘
我選了一個都市傳說:日本的彗星獵人木內鶴彥,說自己 22 歲時被宣告死亡,約 30 分鐘後醒來,而在這 30 分鐘裡,他穿越了時間。
能查到的可靠資訊只有兩件:他確實是業餘天文學家,1992 年重新找到斯威夫特-塔特爾彗星,小行星 5481 以他命名;他年輕時確實有過一次被宣告死亡後又醒來的經歷。我最感興趣的四段奇幻經歷,都沒找到可靠出處:救下童年的自己、看到遠古沒有月亮的天空和大洪水、看到金字塔的建造、發現宇宙是一個巨大的意識。所以片尾加上了「根據木內鶴彥本人的講述改編」。
如果你對這個故事本身感興趣,推薦看 YouTube 上的這集解說,講得非常有意思。後面你會看到,它也是我反思這支片子為什麼不好看的參照。
形式定為 16:9 超寫實,中文旁白加字幕。旁白一開始寫成第三人稱,我覺得太無聊,改成了木內本人的內心獨白。旁白在後製時另外配,想換版本只需要重新配音,不必重新生成影片。
故事:審了三輪,第四版我自己決定
每一版故事都新開一個審查 agent,只給它故事本身,不給任何上下文,讓它像第一次看片的觀眾。
| 版本 | 審查挑出的問題 | 怎麼改 |
|---|---|---|
| 第一版 | 開頭不吸引人,最震撼的巨月和「散成光」分別到第 30 秒和第 48 秒才出現;「救自己」的反轉沒有鋪陳;一個 8 秒鏡頭塞了約 5 個動作;瞳孔裡映出金字塔屬於倒影,AI 拍不出來;醒來那場沒有「意識回到身體」的畫面 | 加上冷開場(巨月加一句「我死了三十分鐘」);先鋪陳「小時候有人喊了我一聲」,再揭曉喊的人是我自己;拆鏡頭;刪倒影;加上光點落回胸口的鏡頭 |
| 第二版 | 孩子看向河岸,和後面「沒有人看得見我」矛盾;幾個人拉巨石不合理;病房俯拍的人太多;旁白口吻不一致 | 孩子只是「聽見」,抬頭看懸崖;移除父親;口吻統一成老年木內的回憶 |
| 第三版 | 「所以我不再怕死」缺少因果;冷開場取自俯拍鏡頭,畫面裡沒有月亮;「沒有月亮」是否定詞,模型反而容易畫出月亮 | 補上因果:死去的我救了活著的我,身體會死,意識卻不會;改成平視;提示詞改用正面描述 |
發現:審查永遠不會自己停下來。每一輪都能挑出真正的問題,但每一輪也會冒出新的、偏向個人口味的意見。原文沒說什麼時候該停。到第三輪,我開始要求審查只把兩類問題列為必須修改:觀眾看不懂,或是影片很可能拍壞。第四版由我決定。
分鏡和色塊草圖
分鏡表照原文要求,每個鏡頭寫清楚景別、機位、運鏡、人物往畫面哪邊走、表情、什麼在動、怎麼接下一鏡。另外幾條規則:平視正面全片只用一次;人的頭或眼睛放在畫面 38% 或 62% 的位置;生成片長比片中長度多留約 1 秒。
配色也先定好:病房冷灰青,童年河邊夏綠加赭石,遠古夜海深藍加骨白月亮,金字塔琥珀色,宇宙黑加青藍。全片只有兩個受保護的強調色:意識的冷白光,和母親的暗紅開襟衫,那是全片唯一的人間暖色。
接著用程式碼,替每個鏡頭畫一張 1920×1080 的色塊草圖:矩形和橢圓代表人物、床、懸崖和月亮,紅線標出 38% 和 62%。
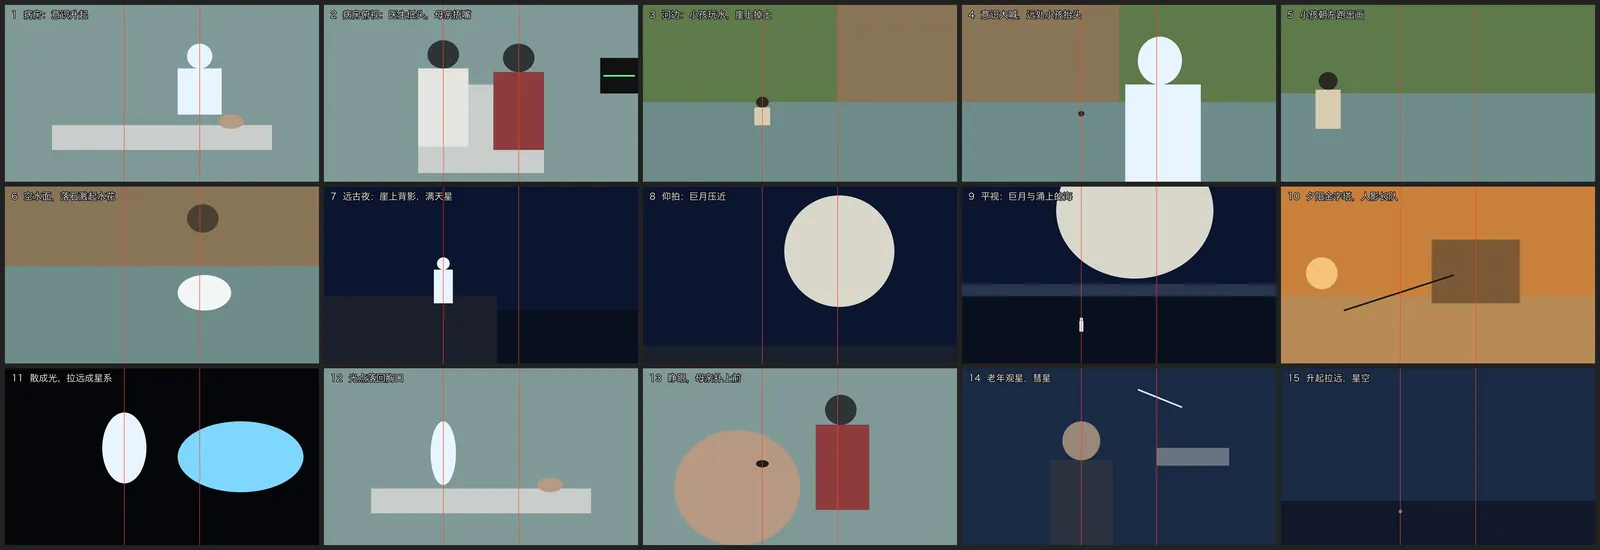
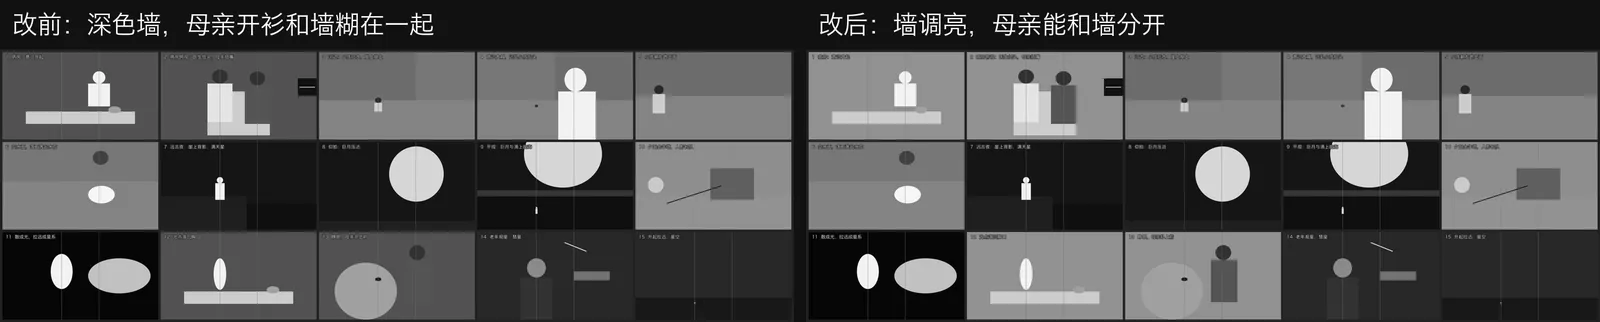
原文的黑白檢查很好用。把草圖轉成黑白後才發現,母親的暗紅開襟衫和深色病房牆幾乎一樣灰,人和背景分不開。把牆從 #3E5A60 調亮到 #7F9996,再檢查一次就分開了。
還有一個鏡頭原本是繞著老人轉的弧形運鏡。兩張靜止的首尾影格很難表現環繞,改成了慢慢推近。
畫風測試和設定圖
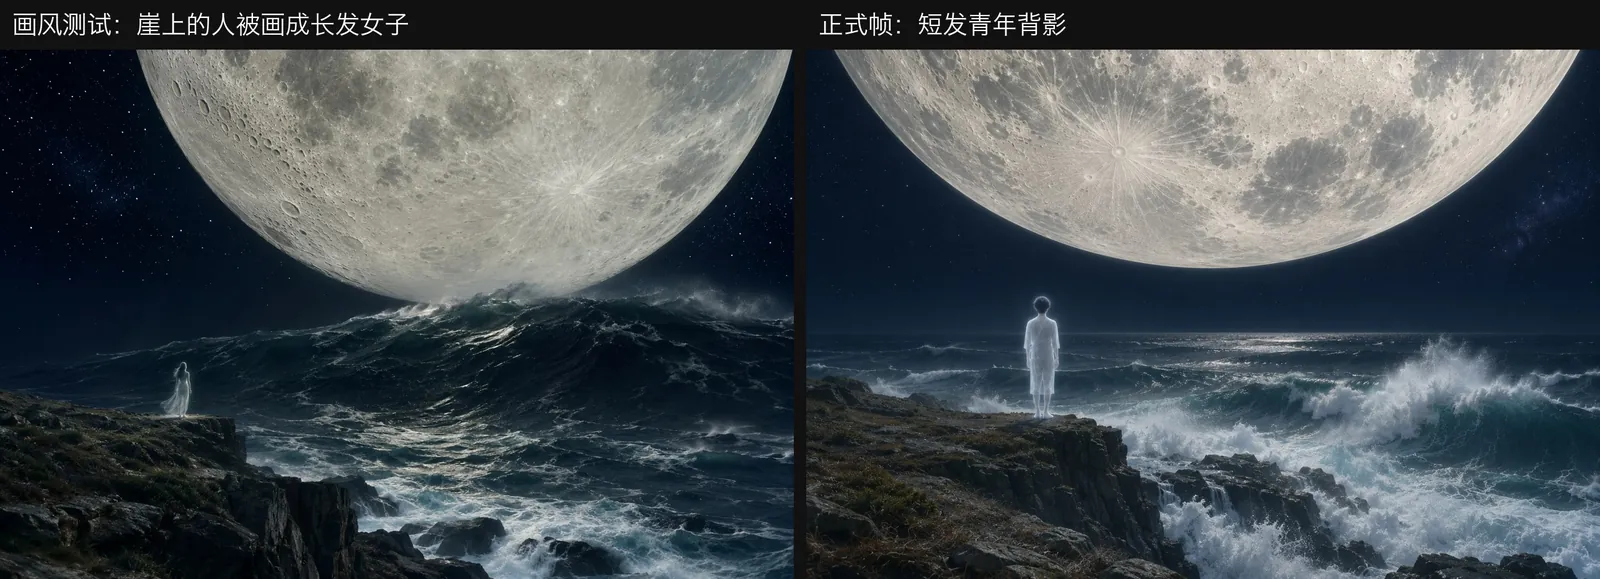
先畫兩張畫風測試:病房和巨月下的海面。病房效果很好;海面那張裡,懸崖上的人被畫成長髮女子,到正式影格才改過來。
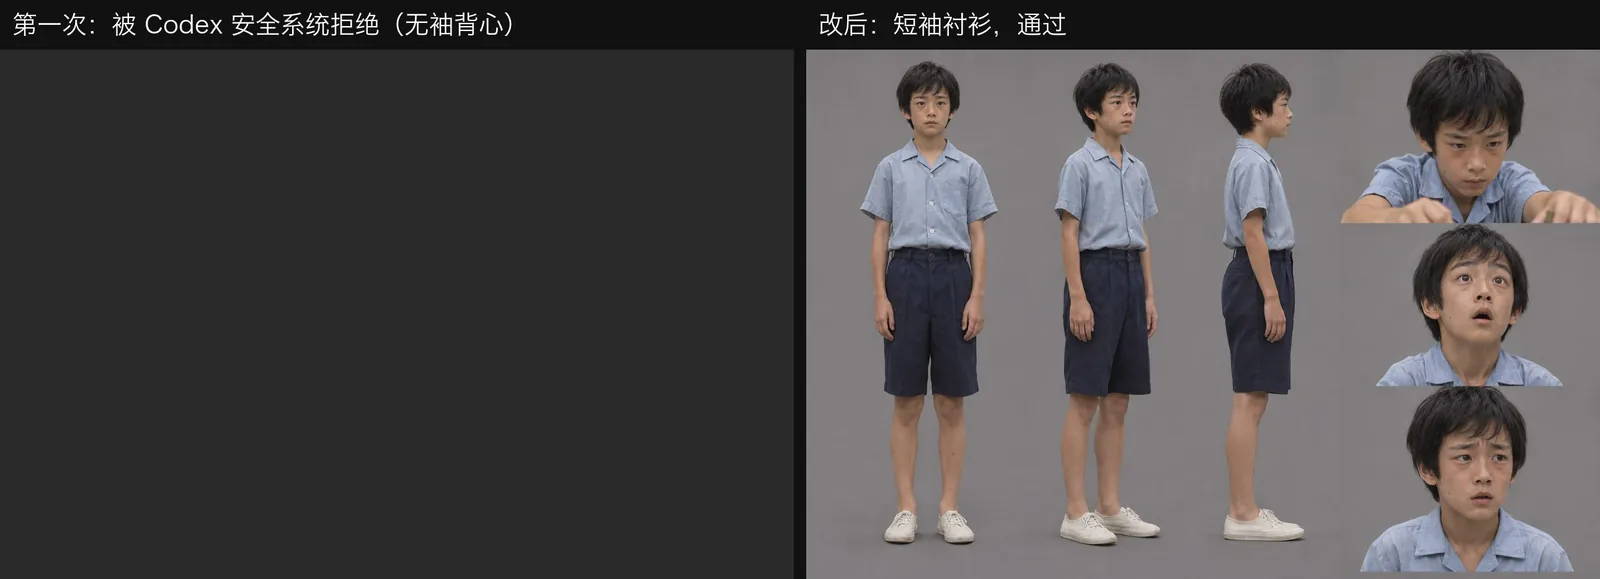
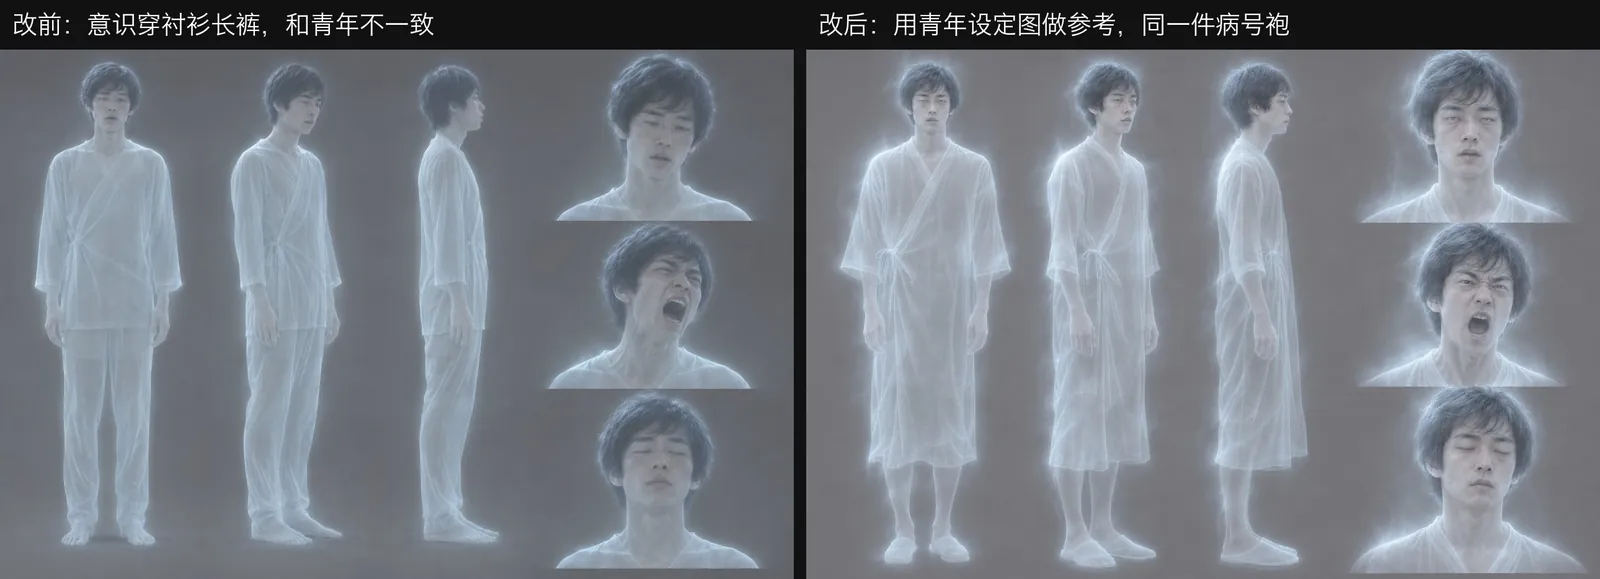
設定圖畫了 5 張:22 歲的木內、他的意識、童年的木內、老年的木內、母親。這一步踩了兩個坑:
- 童年設定圖被安全系統拒絕。第一次寫的是寫實兒童、無袖背心,換成短袖襯衫後才通過。
- 兩個相關角色的衣服對不上。「意識」的設定圖穿襯衫長褲,青年木內穿交領病人袍。後來拿青年的設定圖當參考,重畫了意識。教訓是:相關角色先畫一個,再拿它當另一個的參考。
首尾影格:先寫計畫送審,再畫
原文建議先把每個鏡頭「第一個影格畫什麼、最後一個影格畫什麼、中間發生什麼」寫成文字,審查通過後再畫,這樣能省下出圖額度。第一版計畫沒通過,審查挑出 5 項必須修改的問題:
- 有個鏡頭打算從一張直式圖,上下各裁一塊當首尾影格,但兩塊不重疊,和「頭頂在最後影格的最下緣」矛盾。
- 有個鏡頭往左裁,會把懸崖和大石頭裁掉;「碎土更多」也不是裁切能做出來的。
- 有個鏡頭沒寫臉朝哪邊、光點往哪裡飄。
- 母親要握的那隻手,第一個影格裡根本沒有,影片裡會憑空出現;母親一個人還要連做四個動作。
- 畫風測試裡是圓領病人服,設定圖裡是交領病人袍。
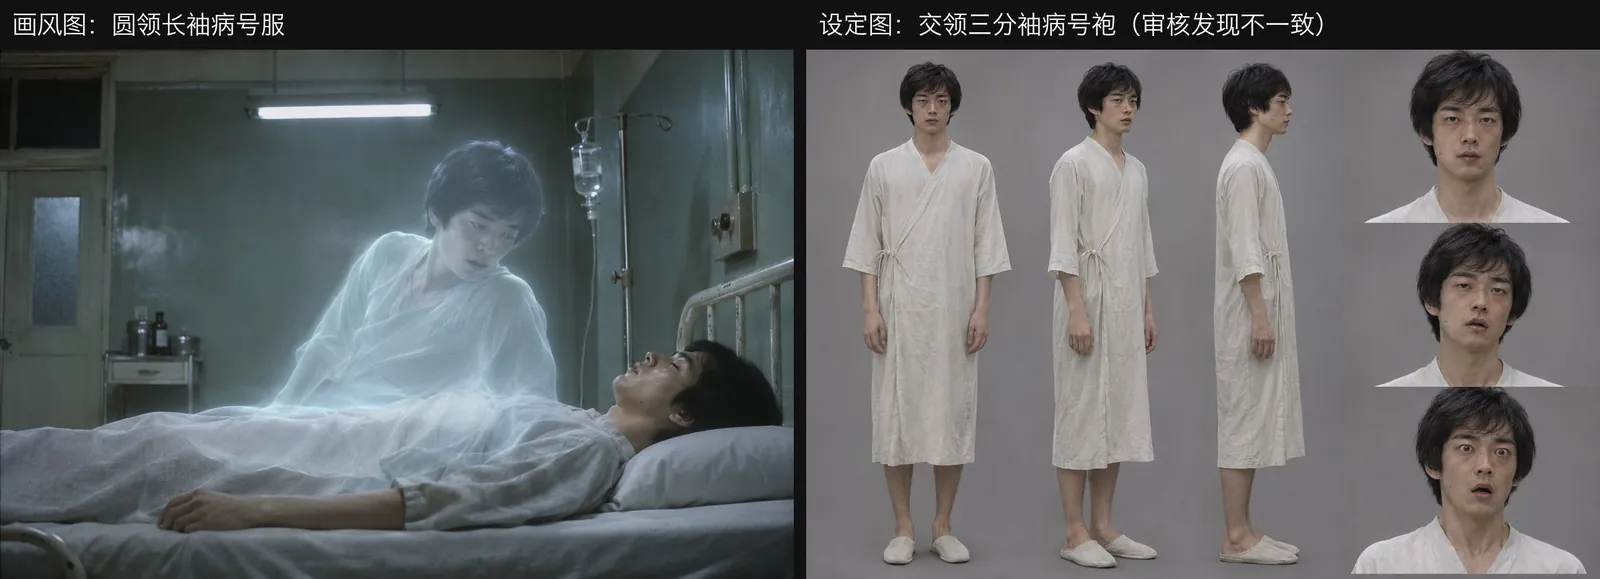
第二版計畫全部改好,還統一了河邊地形:大石頭正好懸在孩子玩水的位置上方,落下時砸在孩子剛才站的地方。
正式出圖約 31 張,分 8 批畫(原文提醒不要一次畫太多)。每張都放大檢查,又抓出幾處錯誤:
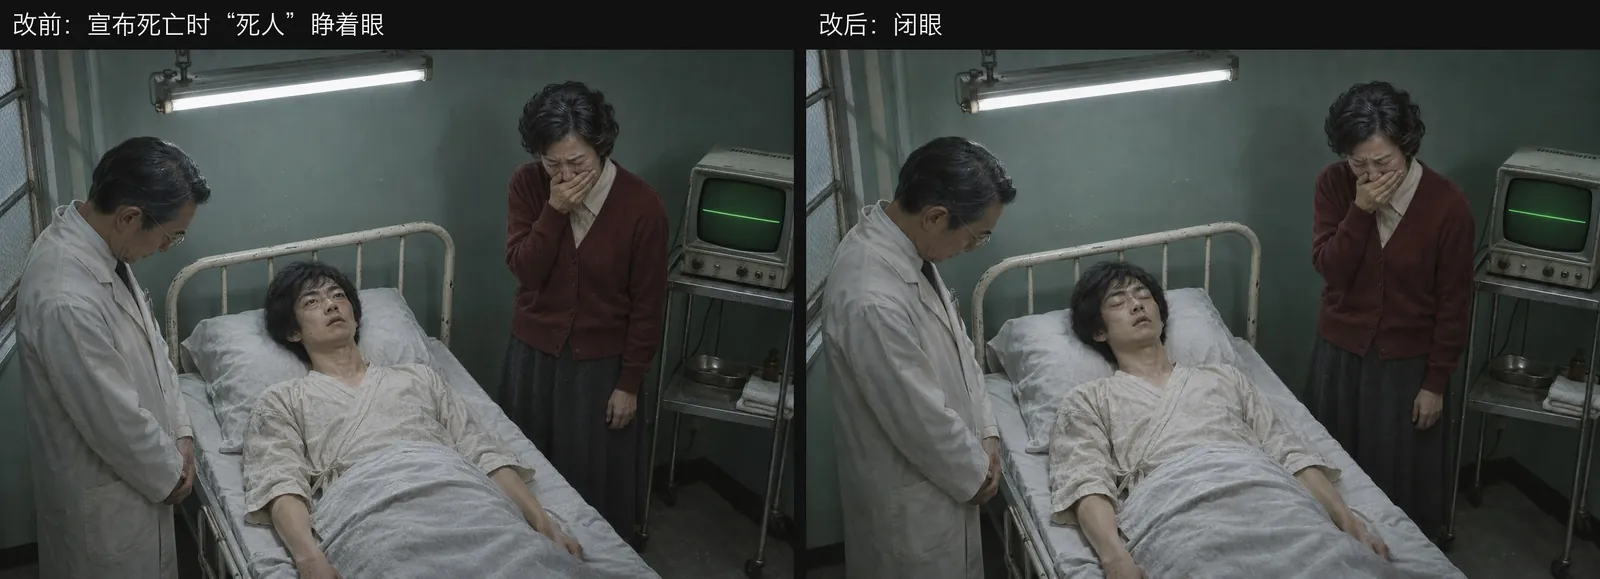
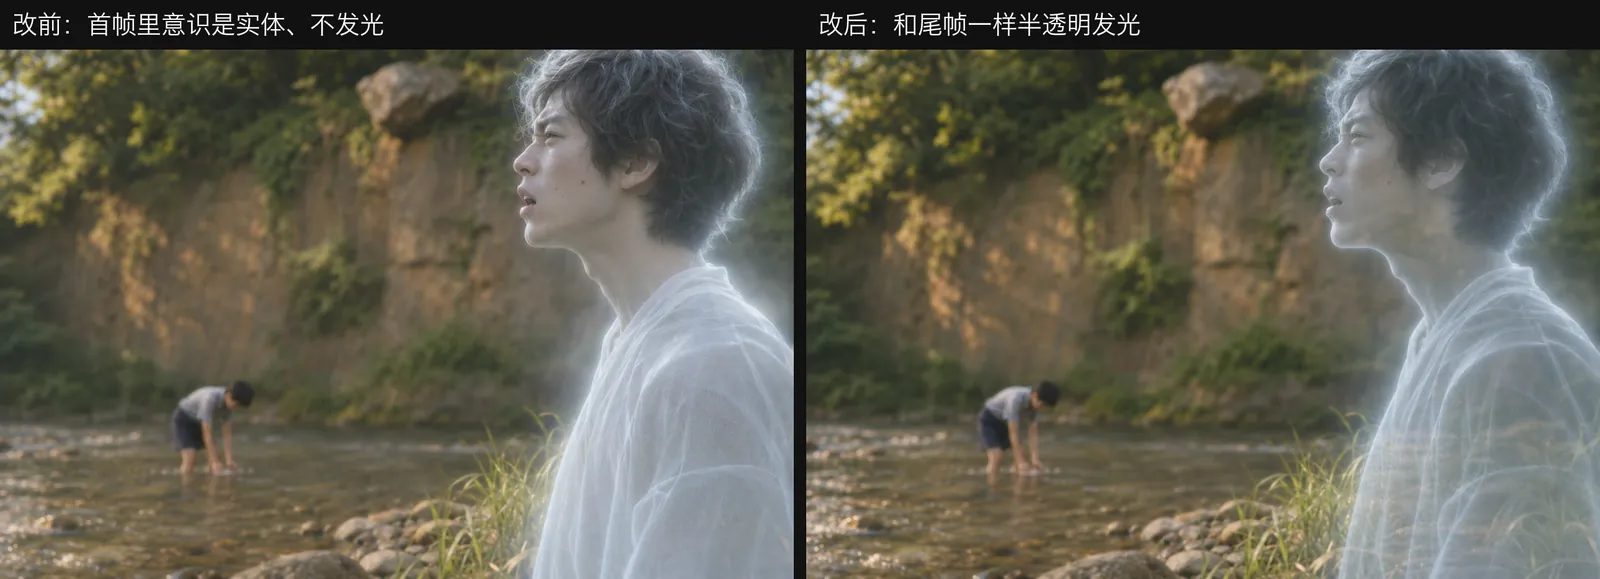
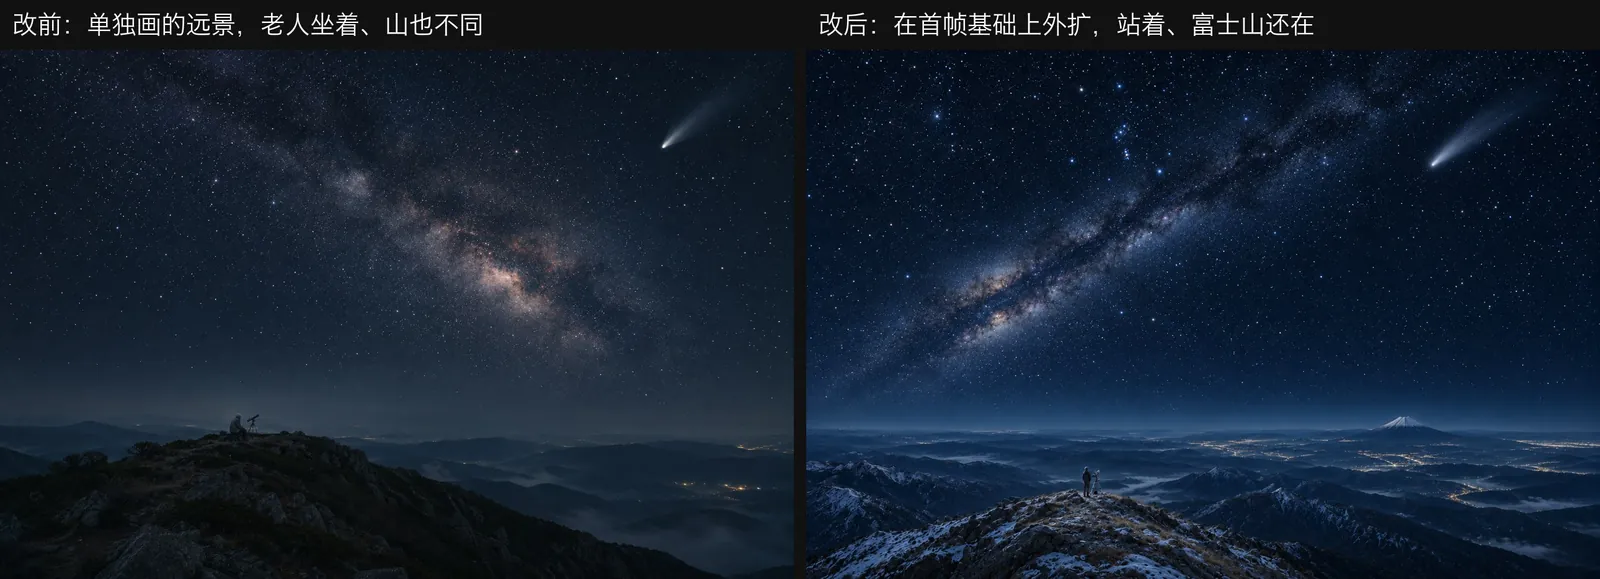
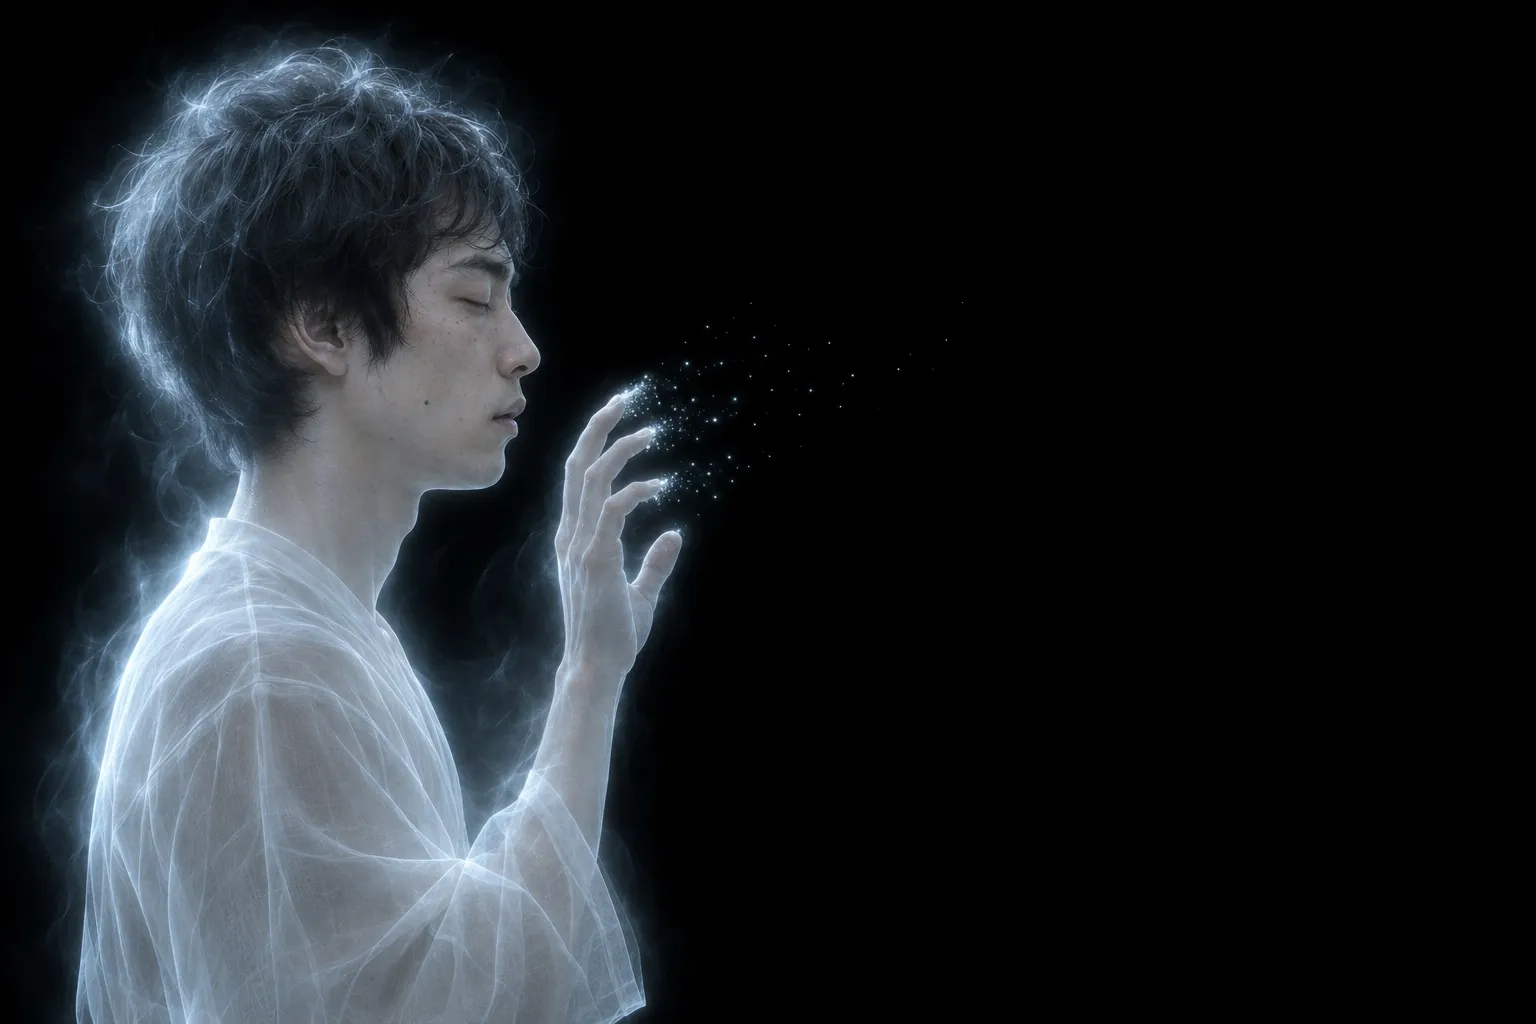
也有意外的好結果:有個鏡頭規劃臉朝左,畫出來卻朝右。光點飄向他面前的黑暗,效果反而更好,就留下來用了。
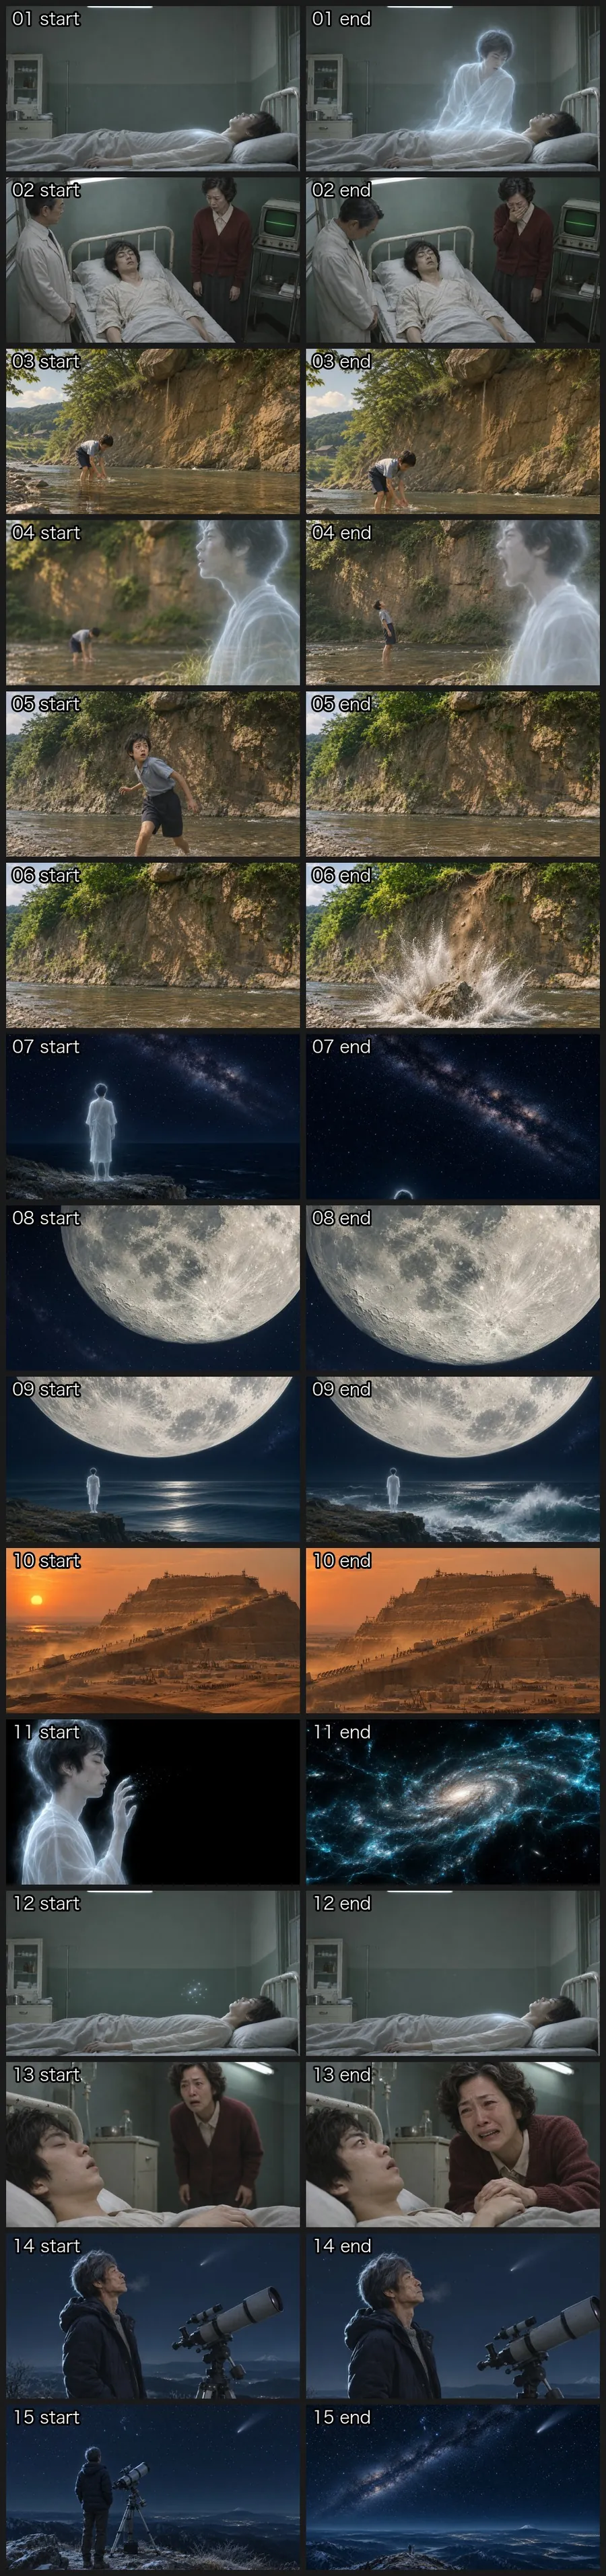
還有兩個原文技巧很實用:推近鏡頭的最後影格,直接從第一個影格裁一塊放大,確保機位完全不變;所有圖統一裁成 16:9,每張單獨決定裁切位置。
影片提示詞:七段式,加一次提交前審查
15 個鏡頭都依原文的七段式寫提示詞:畫風、鏡頭、構圖與配色、人物、逐秒動作、聲音、限制。提交前再開一次審查,7 個鏡頭不通過,而且全是提示詞和圖對不上,不必重畫圖:
- 提示詞要求「向上搖鏡」,但首尾影格完全一樣。
- 聲音裡寫了喊「危險」,模型會讓 1976 年的日本角色說普通話。改成沒有清楚詞語的呼喊。最後影格裡他還張著嘴,提示詞卻說他早就喊完了。
- 提示詞提到的崖頂,兩張圖裡都沒有。
- 「海水漫上海岸」可能把崖邊的人沖走。
- 提示詞說胸口的光變暗,最後影格裡卻還亮著。
- 還有兩個鏡頭,運鏡描述和逐秒動作或最後影格矛盾。
這一輪審查最值錢:每一項都會讓一次付費生成白花錢。
生成:Seedance 拒絕寫實人臉
測試第一個有臉的鏡頭時,Seedance 在建立任務階段就直接拒絕了:
The request failed because the input image 'content[1]' may contain real person.請求被拒絕,沒有扣費。這是整次嘗試裡最大的發現。原文介紹畫風時,把寫實列為選項之一,卻沒有提到這個限制,它的提示詞範例和配圖也都是手繪風格。這套方法直接套到寫實人物上,有臉的鏡頭根本行不通。
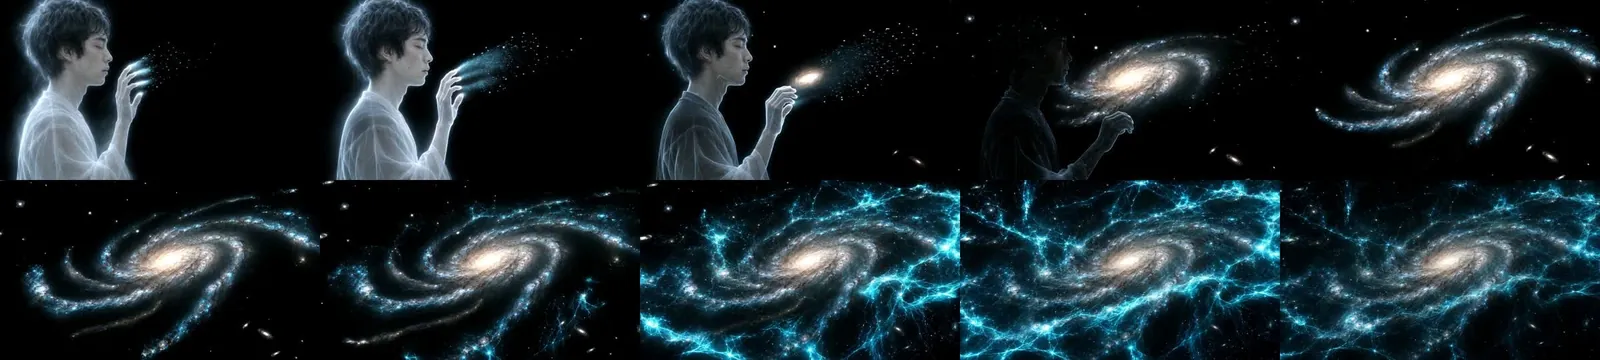
我改用 Kling 生成有臉的鏡頭(舊模型 kling-v2-1 已經下線,要用 kling-v3)。效果不錯,但「散成光」那一鏡裡,人在第 3 到 4 秒會先變成暗色剪影,而不是散成光:
另一個動作複雜的鏡頭,在 Kling 上一次成功,動作順序完全照計畫:
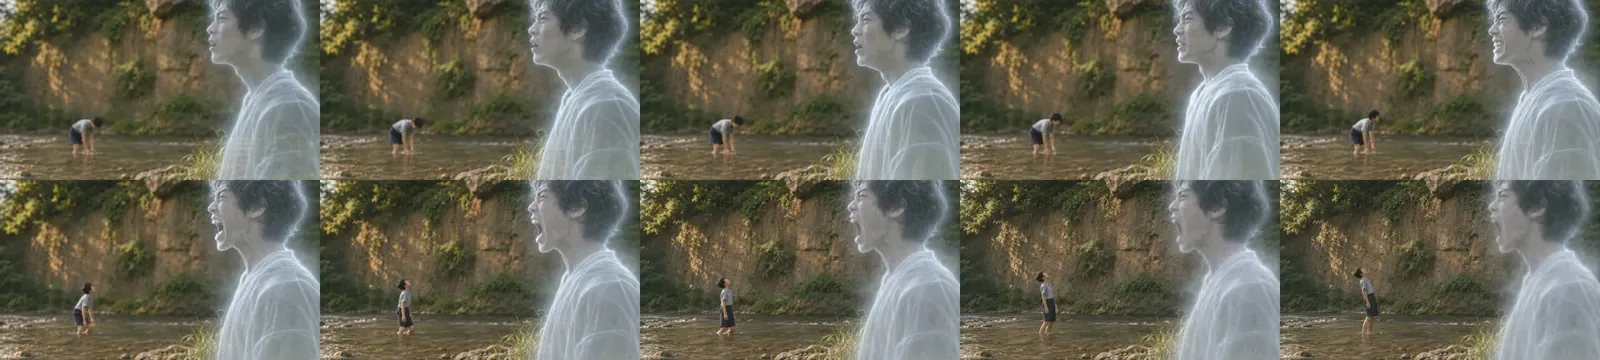
最後的分工是:沒有人臉的鏡頭(落石、月亮、金字塔)留在 Seedance;只有背影或很小人影的鏡頭,先試 Seedance,被拒絕也不花錢;有人臉的鏡頭交給 Kling。
- Seedance 6 個鏡頭全部一次通過。其中兩個鏡頭有背影或很小的人影,也沒有被過濾,看起來它的過濾針對的是可辨認的人臉。
- Kling 9 個鏡頭也全部一次通過。宣告死亡的那一鏡,我把臉放大、逐秒檢查,10 秒內一直閉著眼。
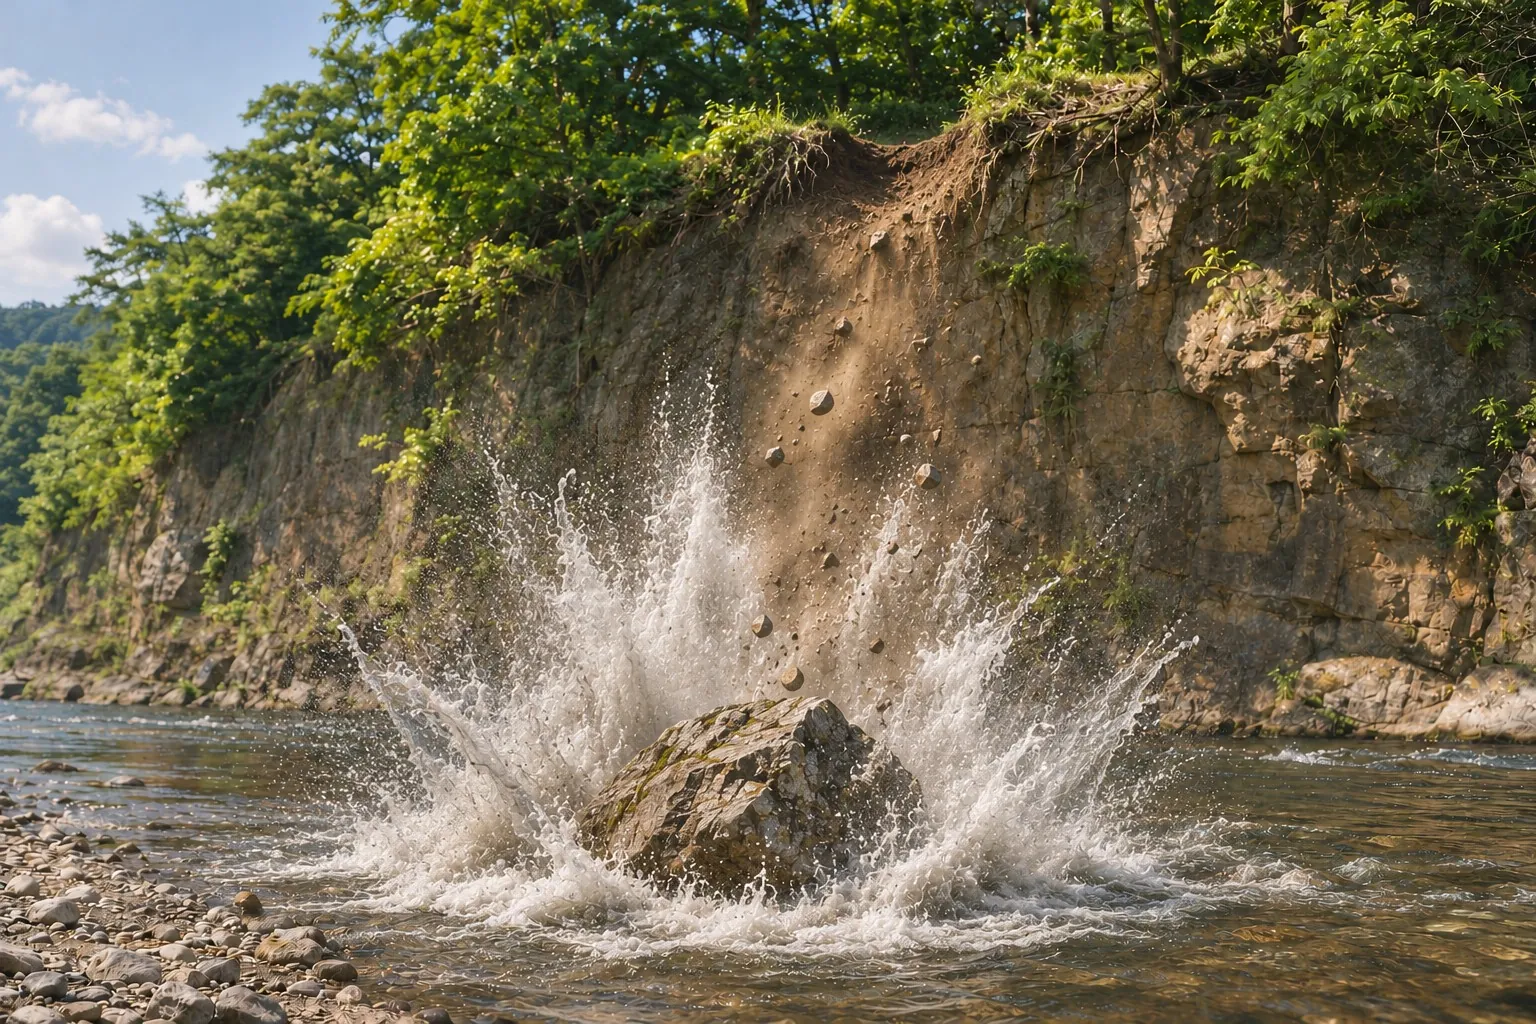
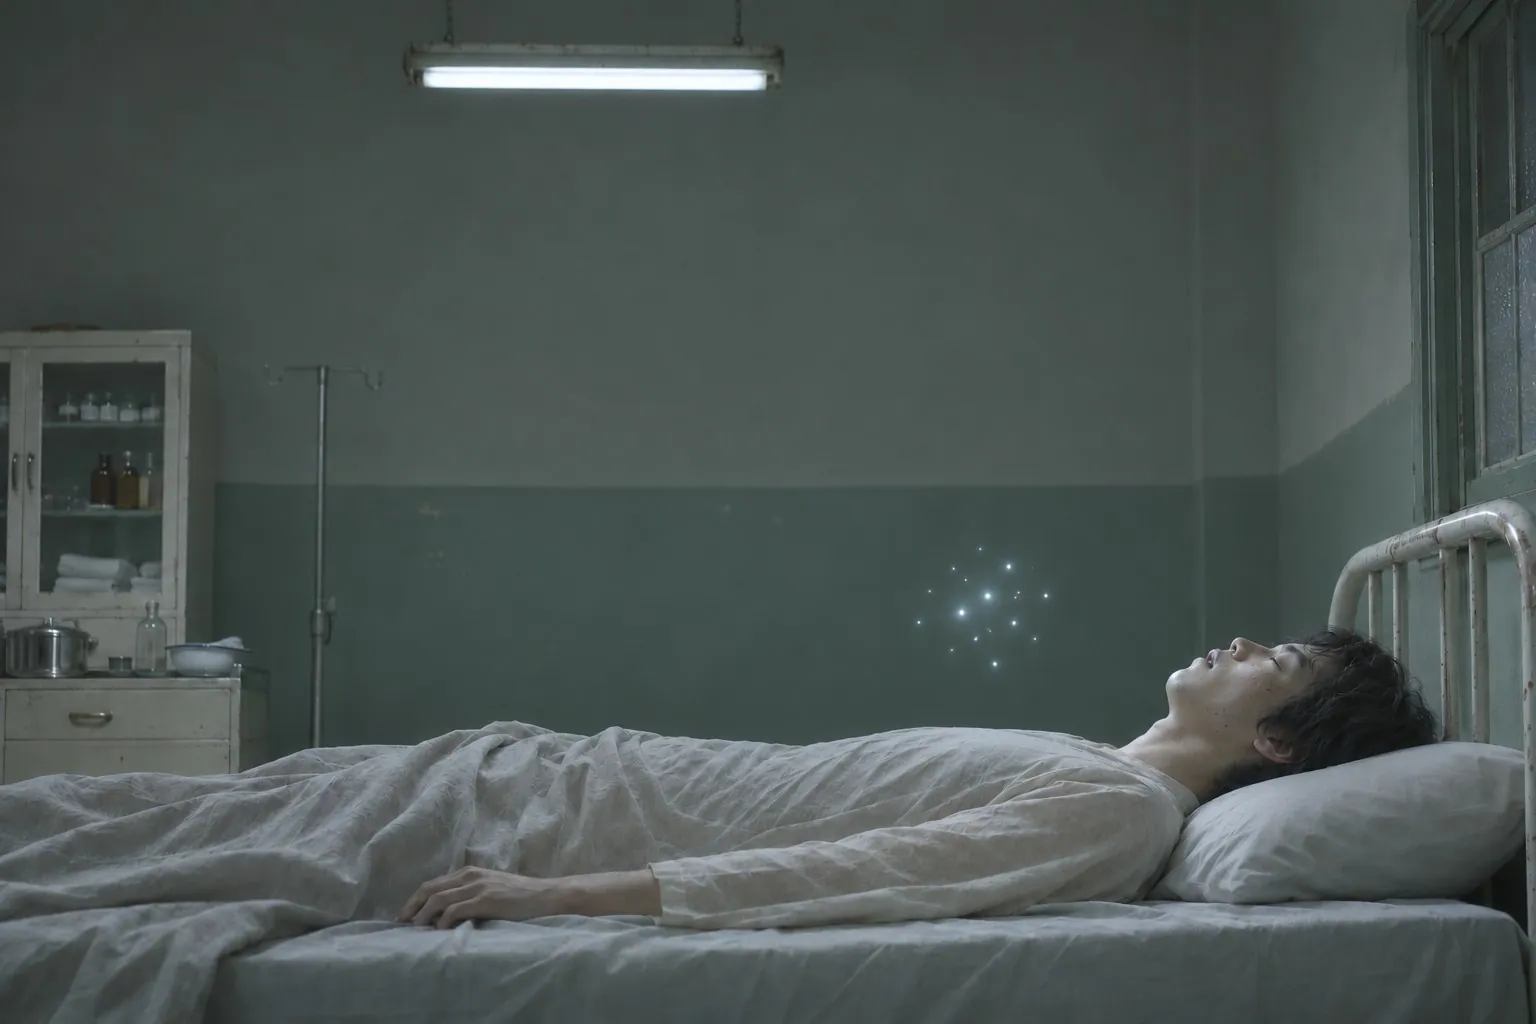
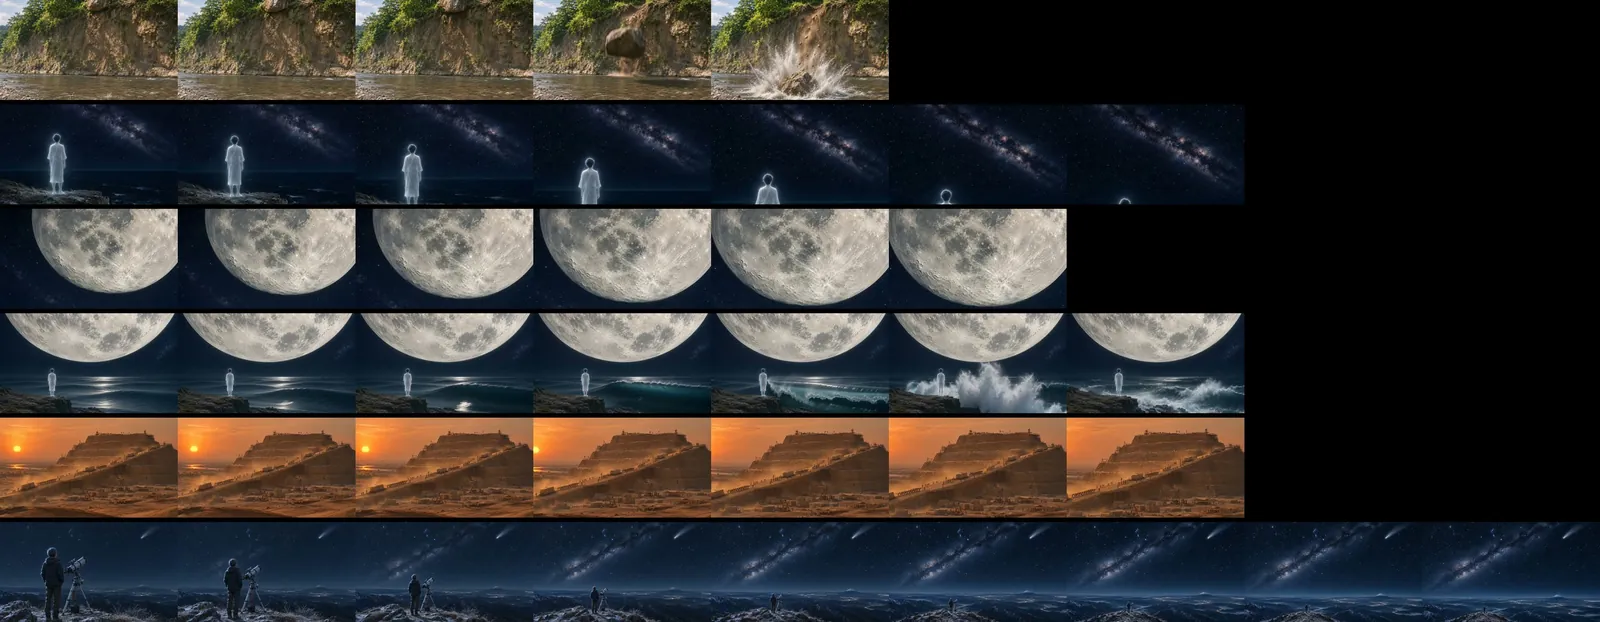
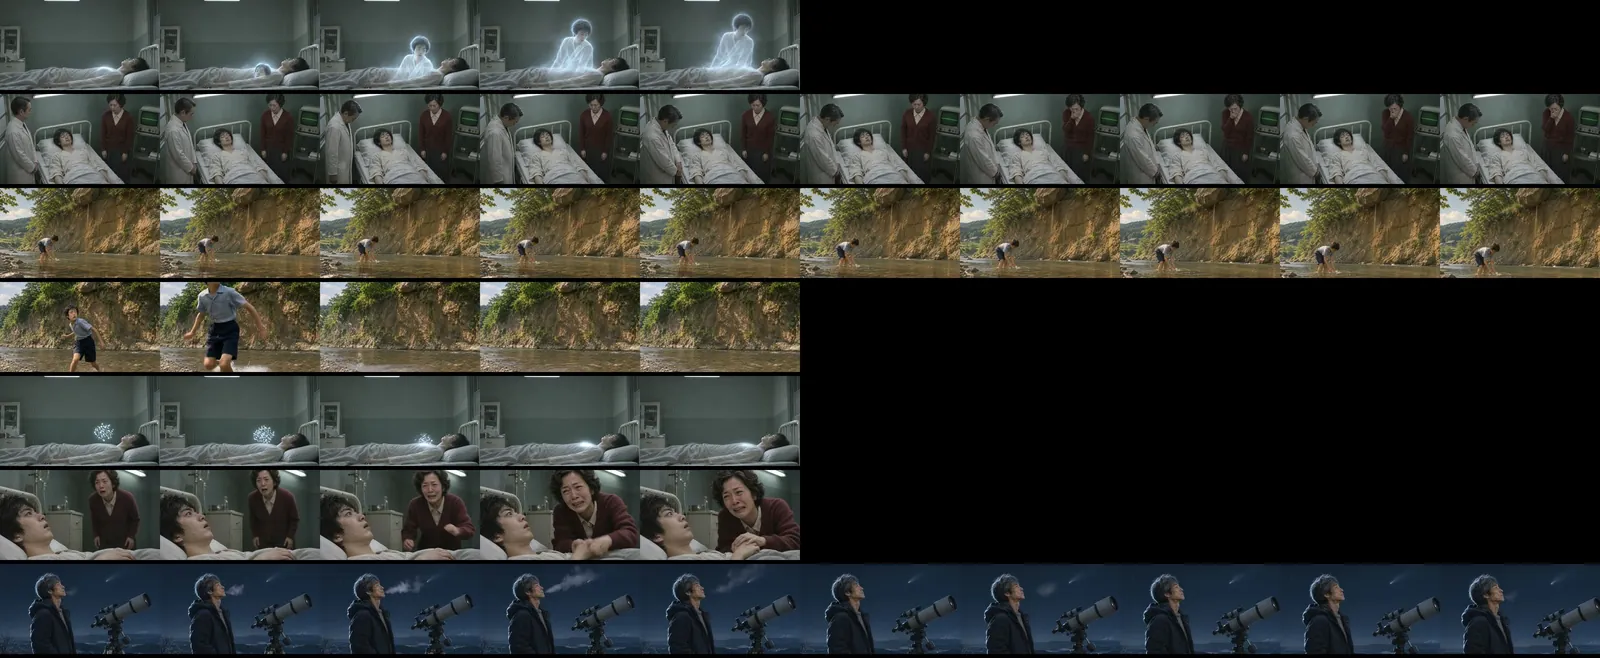
15 個鏡頭,沒有一個需要重拍。這表示前面幾輪審查確實有效。
粗剪和配音:像 PPT
先做無聲粗剪,84 秒,每個鏡頭依片中長度調整速度後串起來。我自己的感受是:單個畫面都好看,但鏡頭之間莫名其妙、不連貫,四個故事不夠震撼,也不夠獵奇,沒有想看下去的慾望。
再做配音版,1 分 56 秒:Gemini 的 Charon 聲音念中文獨白,加上白閃轉場、低頻環境底噪、醒來前的心跳,再保留 Seedance 內建的落水聲和海浪聲。字幕依句子切開,鏡頭長度改成跟著旁白走。片子比計畫長,因為這個聲音念得很慢,大約每秒 3 個字。還有個小插曲:Gemini 怎麼都不肯念單獨一句「危險!」,連續 6 次都沒回傳音訊,改成「危險,快跑!」才行。
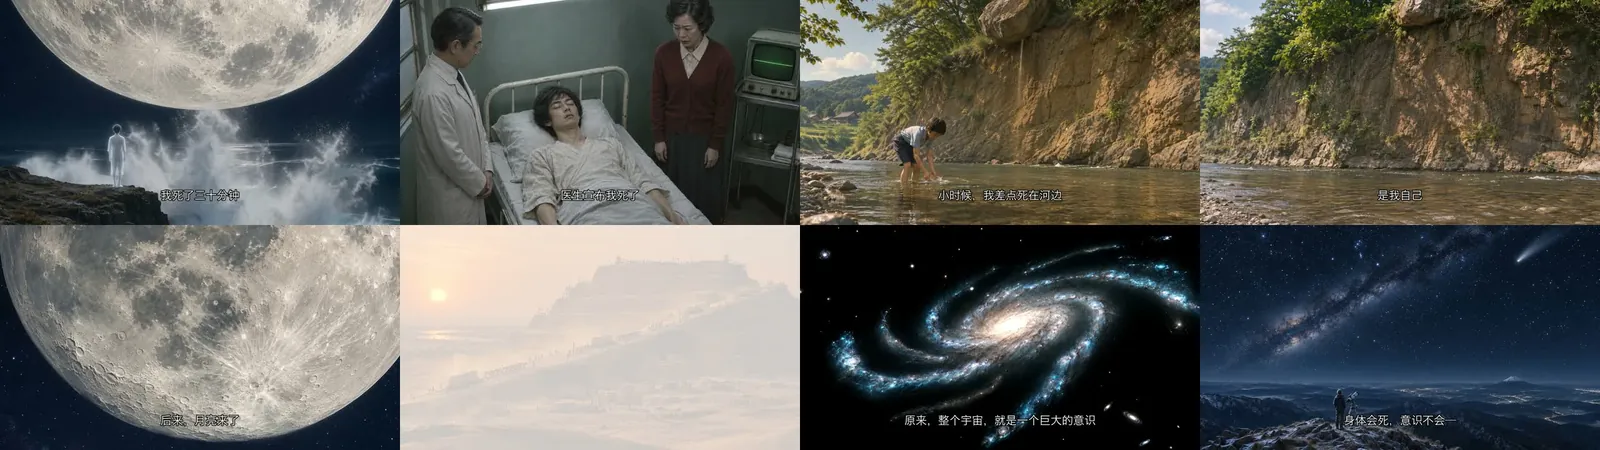
旁白有氣無力,畫面一張張翻過去,像在看 PPT。我看完只覺得無聊。我之前在 YouTube 上看過別人講這個人的故事(就是前面推薦的那集),非常有意思,所以問題不在題材。
花了多少錢
| 項目 | 花費 |
|---|---|
| Codex 出圖:約 31 張正式影格、5 張設定圖、2 張畫風測試 | 用 ChatGPT 方案額度,不另外花錢 |
| Seedance 2.0:6 個鏡頭,720p,約 89 萬 token | 約 $6.2 |
| Kling v3 pro:9 個鏡頭,約 44 units | 約 $6 |
| Gemini 配音 | 幾乎免費 |
| 被拒絕的請求(真人過濾、已下線的模型) | 不扣費 |
| 影片生成合計 | 約 $12 |
原方法裡最值得學的
除了 Seedance 的真人過濾,這套方法我幾乎是照原文做的:故事、分鏡、畫風、設定圖、首尾影格、提示詞、審查、報價,確認之後才花錢。下面這些在我這次嘗試裡最有用:
- 每一步都另外開審查 agent,不給上下文,讓它像第一次看的觀眾。
- 確認故事之前不畫圖,確認畫風之前不畫正式鏡頭。
- 先把首尾影格計畫寫成文字送審,通過後再畫。
- 黑白檢查:彩色裡分得開的顏色,黑白裡可能一樣灰。
- 先畫內容多的最後影格,再改出第一個影格;推近鏡頭直接從第一個影格裁切放大。
- 七段式提示詞,並且用正面描述代替「不要……」。
- 提交前核對提示詞和圖是否一致。這一步擋下了 7 個鏡頭的錯誤。
- 先拿最難的鏡頭試;新版本存成新檔案,不覆蓋舊的。
我覺得問題可能出在哪裡
下面是我自己的猜測,只針對這一次的做法,不一定對。
- 講法不對,不是故事不行。別人在 YouTube 上講這個故事很好看,因為那是在「講故事」:有懸念,有反問,講述者有情緒,資訊一層層揭露。我們做成了「配圖朗讀」:每段經歷只有兩三個鏡頭、十幾秒,只夠把畫面擺出來,不夠讓觀眾好奇。
- 我的審查只管「對不對」,不管「好不好看」。在「把錯擋在花錢之前」這件事上,審查非常有效。但我讓審查追求的是清楚、合理、AI 拍得出來,奇怪的、危險的、刺激的點子都被磨平了。我沒有安排任何一步,去檢查觀眾想不想看下去。
- 片段式結構可能需要音樂和剪接來支撐。原文首選片段式,因為不必連戲,最穩。但片段式的鏡頭之間沒有因果,我猜要靠音樂踩點、剪接節奏和強烈的旁白串起來。原文範本裡特別留了配歌的寫法:轉折對副歌,關鍵動作對重拍。我們沒有音樂,只有一個慢吞吞的 TTS 聲音,片段之間就散了。
- 畫面太安靜。超寫實畫面每個影格都好看,但大多是緩慢推近、人物站著。原文要求「畫面裡一直要有東西在動」,我們只做到「有一點在動」,沒有張力。
- 這個 TTS 聲音撐不起講述。講故事的影片,講述者的語氣很重要。這個聲音平、慢、沒有起伏,而旁白又決定了每個鏡頭的長度,整支片子都被它拖慢了。
如果再做一次
我會先試試這四件事:
- 在故事階段加一個「好看程度」審查,問的是「這裡會讓人想看下去嗎、哪裡會滑走」,而不只是邏輯對不對。
- 先決定音樂和節奏,再決定鏡頭。
- 替審查循環設定一個停止條件。
- 做寫實畫風之前,先確認平台對真人的限制。
如果你看出了問題到底在哪裡,或是用類似流程做過好看的片子,非常想聽聽你的看法,歡迎寄信給我:contact@caolibin.com。