抖音為什麼越滑越懂你?看懂短影音推薦系統
一位新使用者第一次打開抖音,系統對他一無所知。可是滑不到半小時,推薦過來的影片就開始「對味」了。這中間發生了什麼?我最近讀完了一個開源的短影音推薦專案,這篇跟著一位虛構的新使用者小林,從他滑到的第一支影片講起,把整個流程走一遍。
先說清楚材料:我讀的是 GitHub 上的 kuairand-short-video-recommender,用的是快手公開的 KuaiRand 資料集(約 2.7 萬名使用者、7,600 支影片、一個月的真實行為)。它不是抖音的原始碼,但結構和大型科技公司公開談過的做法一致。文中的數字都來自這個專案。
第一次滑:系統對你一無所知
推薦系統眼裡的世界,可以畫成一張大表:每一列是一位使用者,每一欄是一支影片,格子裡記著「這個人喜不喜歡這支影片」。
小林是新使用者,他那一列是空的。
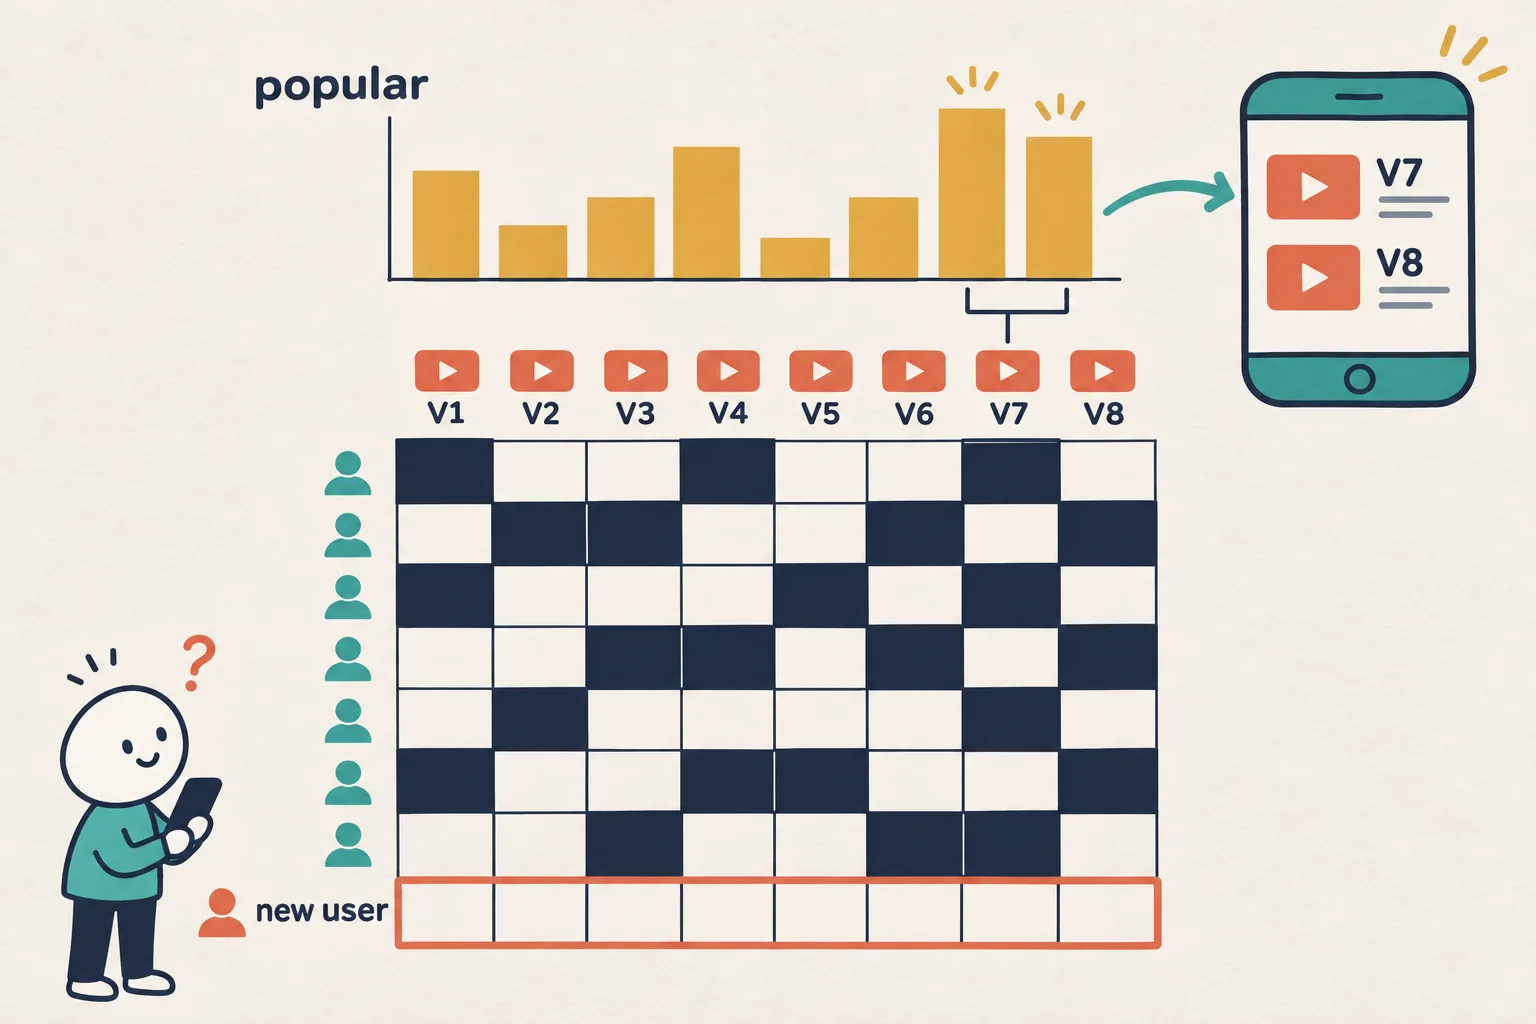
不知道一個人喜歡什麼,最穩的方法就是推薦大家都喜歡的。所以小林第一次滑到的,基本上是熱門影片,再依類別混入各類熱門內容,讓他有機會表現出偏好。這叫冷啟動。
專案裡依使用者的活躍程度調整權重:越不了解的人,越依賴熱門;越了解的人,越相信個人化模型。這個簡單的策略,讓新使用者的長時間播放率提升了 64%。
你滑的每一下都在被記錄
小林滑到第一支影片,一隻貓正在拆家。他看完了,又重播了一遍,沒按讚。第二支是麻辣燙探店,兩秒就滑走了。
這兩件事都會被記下來,而且「看了多久」比「有沒有按讚」重要得多。在這份資料裡,按讚率只有 1.85%,長時間播放率卻有 33%。只靠按讚,模型幾乎學不到東西。所以系統判斷「喜歡」的主要依據是:有沒有看完、看得夠不夠久、有沒有按讚,三者有其一就算。
每次回饋都會立刻更新小林的「近況」:最近看過的、最近喜歡的影片清單。但它不會馬上替換手機裡已經收到的影片。App 每次只拿一小頁(十支左右),快看完時再請求下一頁,新的一頁才用上更新後的近況。一頁很小,所以感覺上幾乎是即時的。
從海量影片裡先撈 500 支:召回
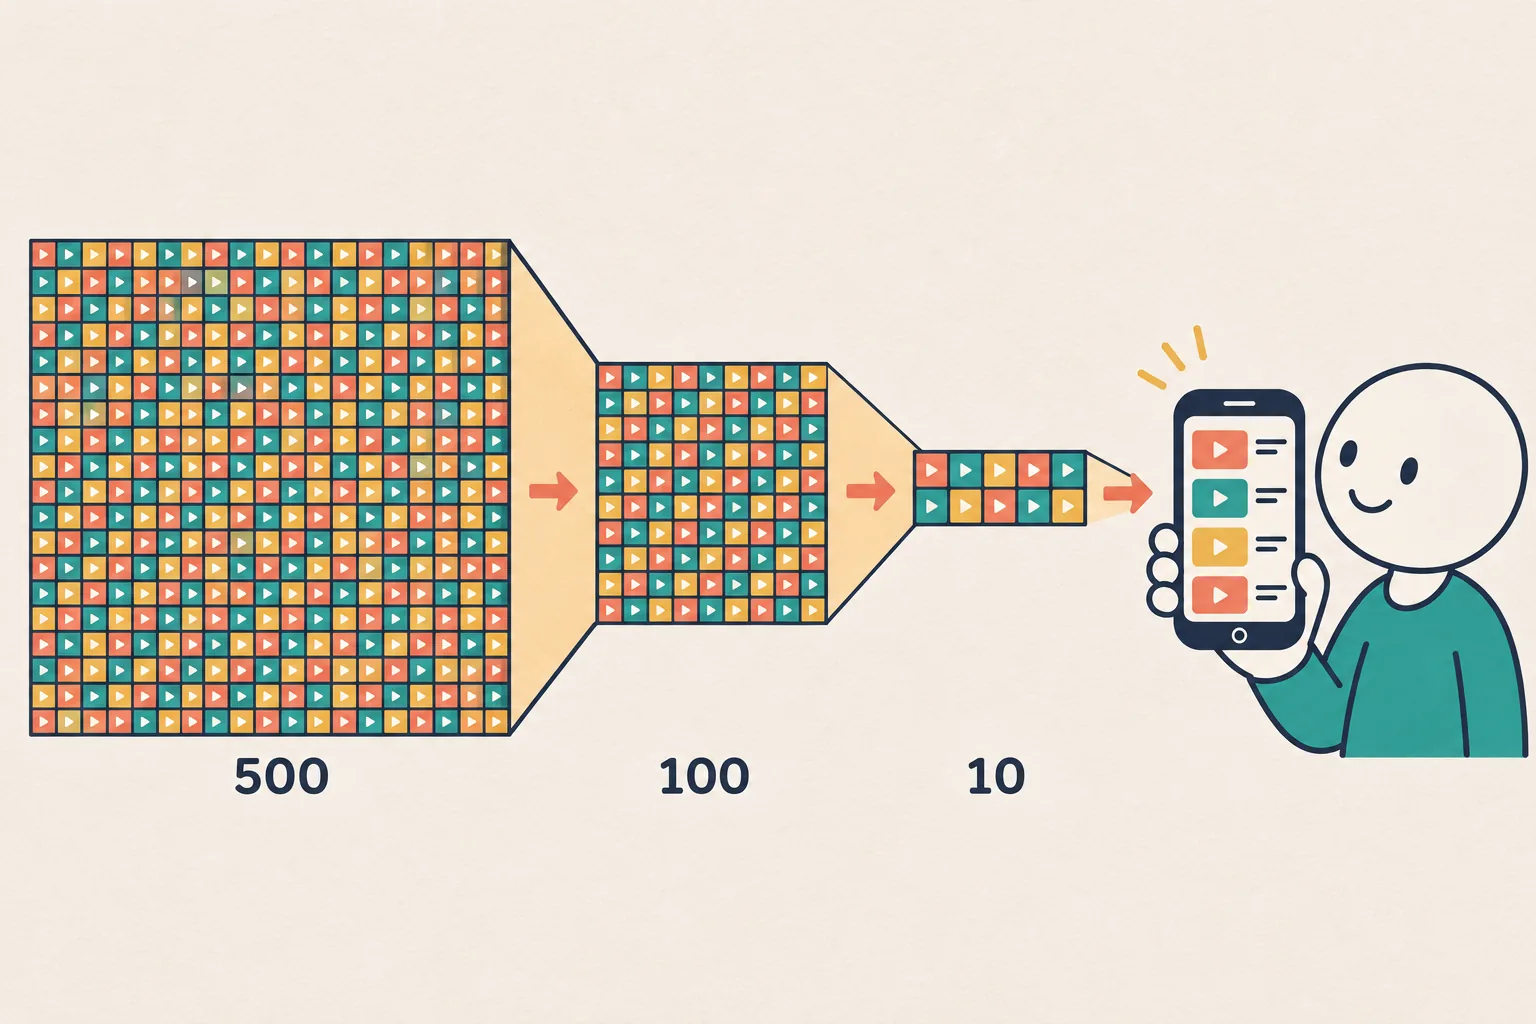
抖音有上億支影片,再準的模型也不可能每次重新整理,都替所有影片評分一遍。所以第一步是召回:用又快又粗略的方法,先撈出 500 個候選。召回的目標不是排得準,而是別漏掉:沒被撈進來的,後面再厲害也推薦不出來。
召回有好幾路同時進行,每一路抓一種「喜歡」的理由。最重要的兩路:
ItemCF:看了這個的人還看了
回到那張大表,這次直著看。如果兩支影片總是被同一群人喜歡,它們就算相似。系統每天離線計算一遍,替每支影片存一份「相似影片清單」。
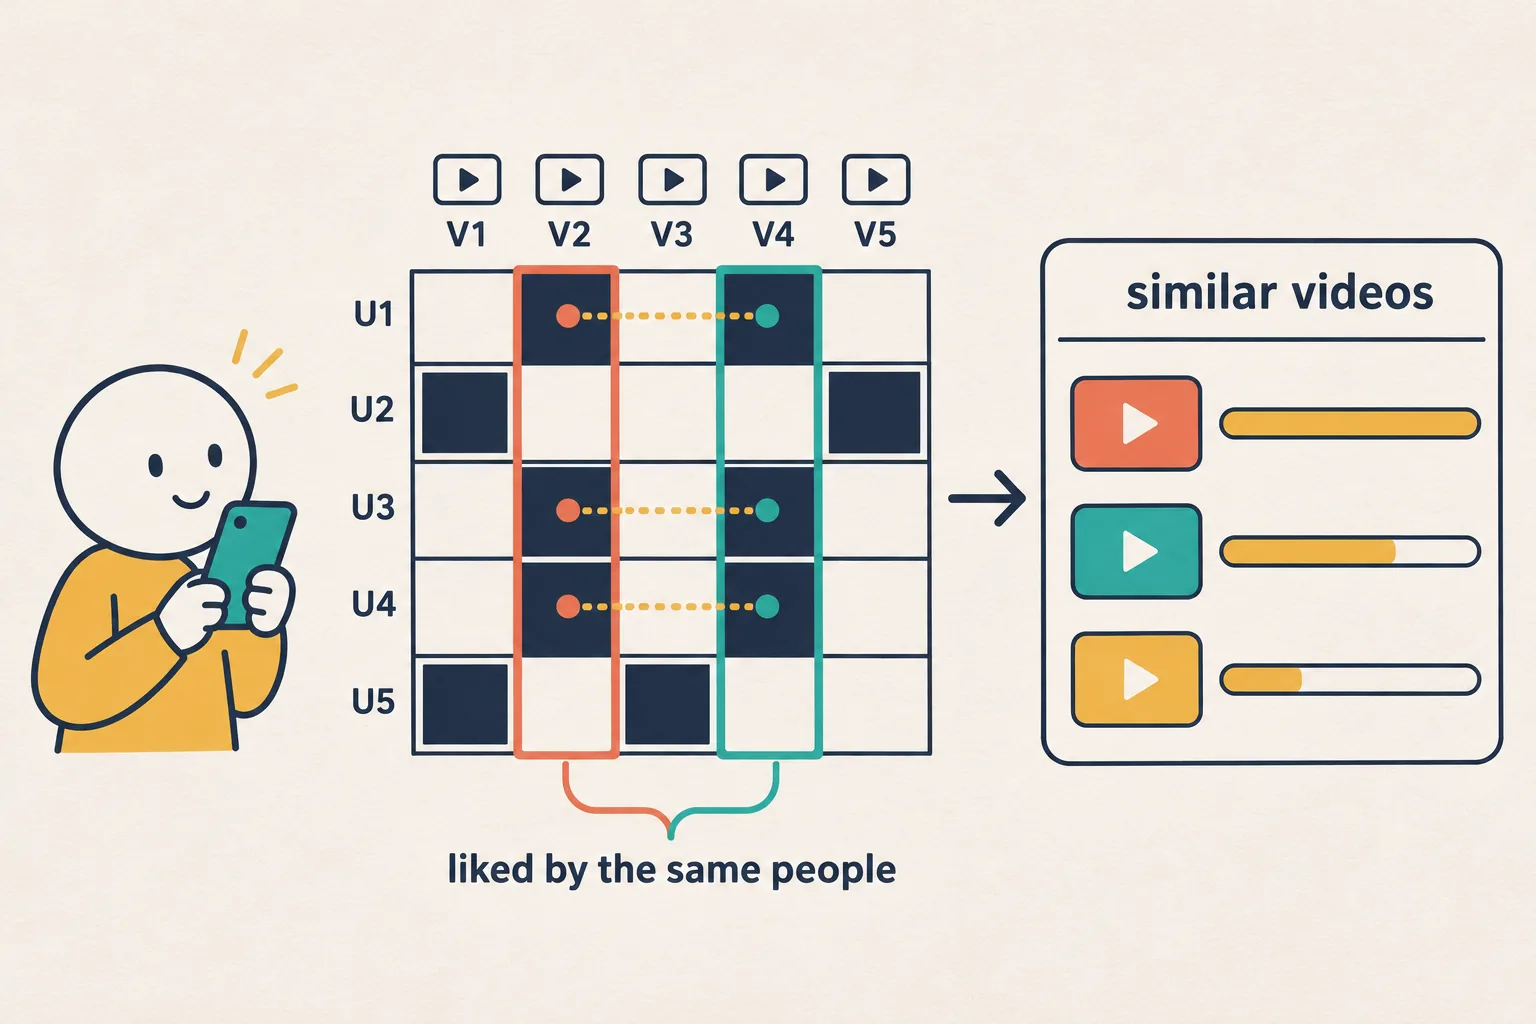
小林重新整理時,系統拿他最近看過的影片逐一查清單,越近期看的權重越高,相同鄰居的分數相加。貓咪拆家的清單裡有「貓 B」,於是貓 B 進了候選。
它的好處是不必訓練,只要計數;缺點是只認「被一起看過」,兩支從沒被同一個人看過的影片,它永遠不知道它們像不像。
雙塔:把人和影片都變成座標
雙塔模型替每位使用者、每支影片各學一個 64 維向量,可以理解成它們在「口味空間」裡的座標。離得近,就表示合拍。
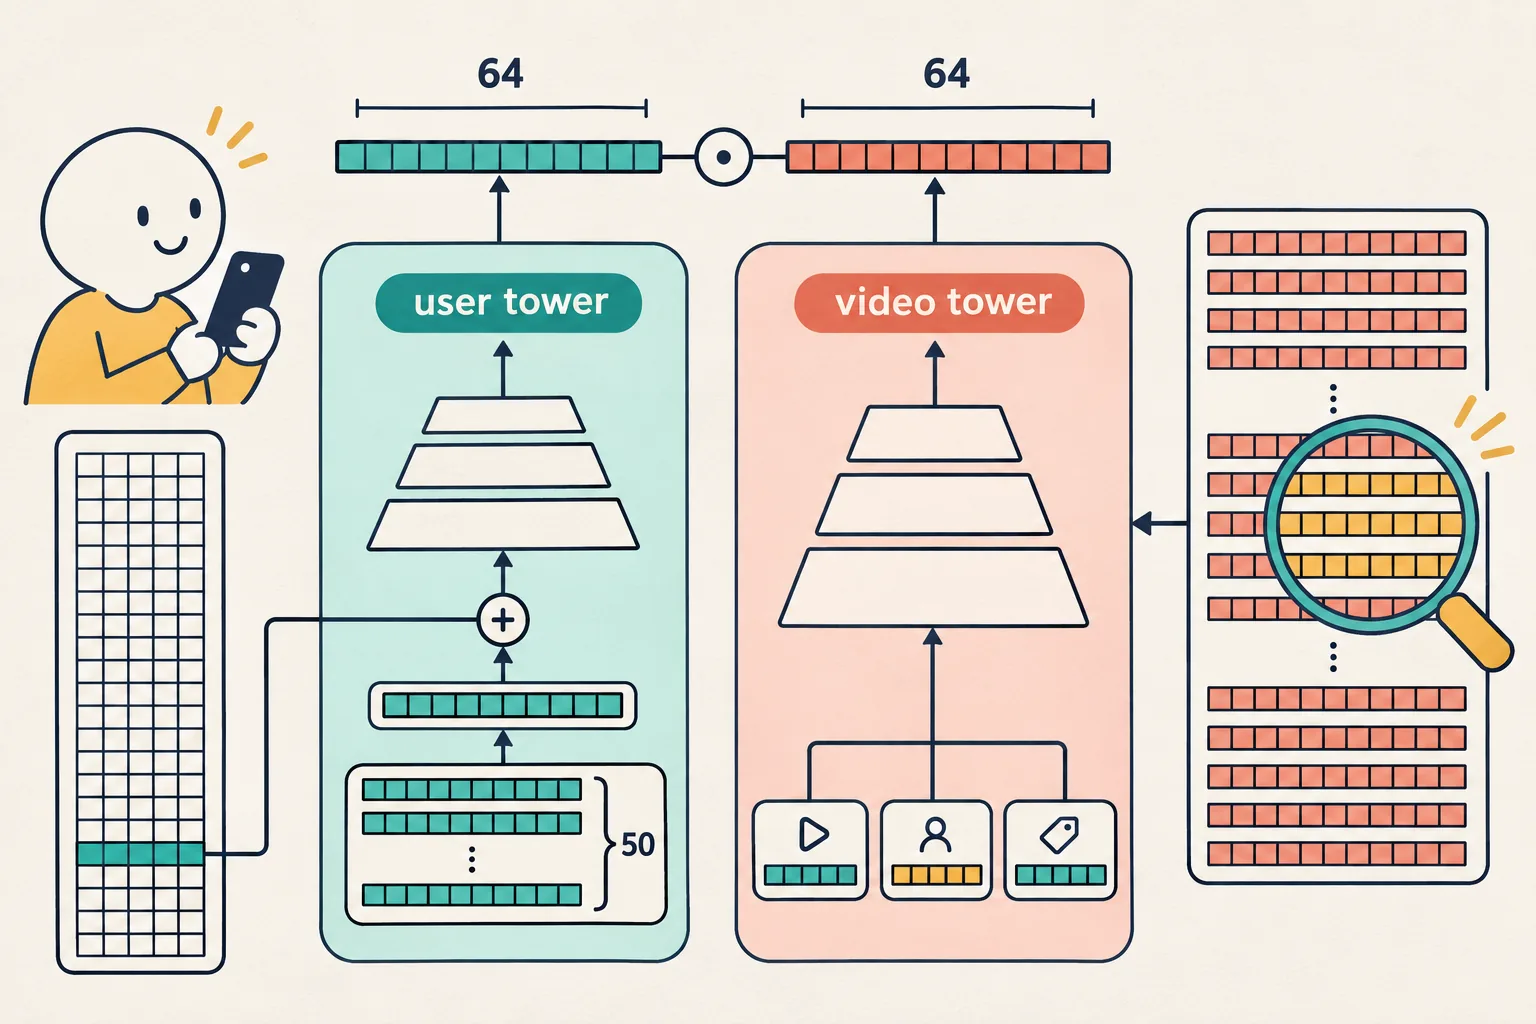
- 使用者塔:小林的 ID 向量,加上他最近 50 支影片向量的平均,經過一個小型神經網路,得到「小林向量」。
- 影片塔:影片 ID 向量、作者向量、標籤向量,同樣得到一個影片向量。
這些向量一開始都是隨機數,靠訓練一點點調整:被同一群人喜歡的影片,會被拉得越來越近。它比 ItemCF 多了一項本事:兩支影片就算沒被同一個人看過,只要觀眾口味相近,向量也會靠在一起。
兩座塔互相獨立,這是它快的關鍵:所有影片的向量可以事先算好。線上只要算一次小林向量,再去找最近的影片。找的時候不是逐一比較,而是用 FAISS 這類近似檢索函式庫,沿著一張「相似關係網」跳幾十步,就能找到大部分最近鄰。
另外兩路簡單一些:熱門就是第一次滑影片時用的那份排行榜,給誰都能用;圖召回把影片連成一張關係網,找「朋友的朋友」,補上一些要多繞一步才相關的影片。
幾路召回合併、去除重複,每人留下 500 個。在這個專案裡,這 500 個撈到了測試期間全部「喜歡」的 52.5%。這就是後面所有階段的上限。
500 個怎麼變成 10 個:粗排、精排、重排
粗排用一個輕量的決策樹模型(LightGBM),把 500 個刪減到 100 個。它最重要的特徵之一,就是各路召回給的分數:它在學「怎麼更聰明地組合召回的意見」。
精排是整個漏斗裡最準、也最貴的一層。這個專案用的是阿里提出的 DIN(深度興趣網路),核心想法很好懂:興趣要看對象。
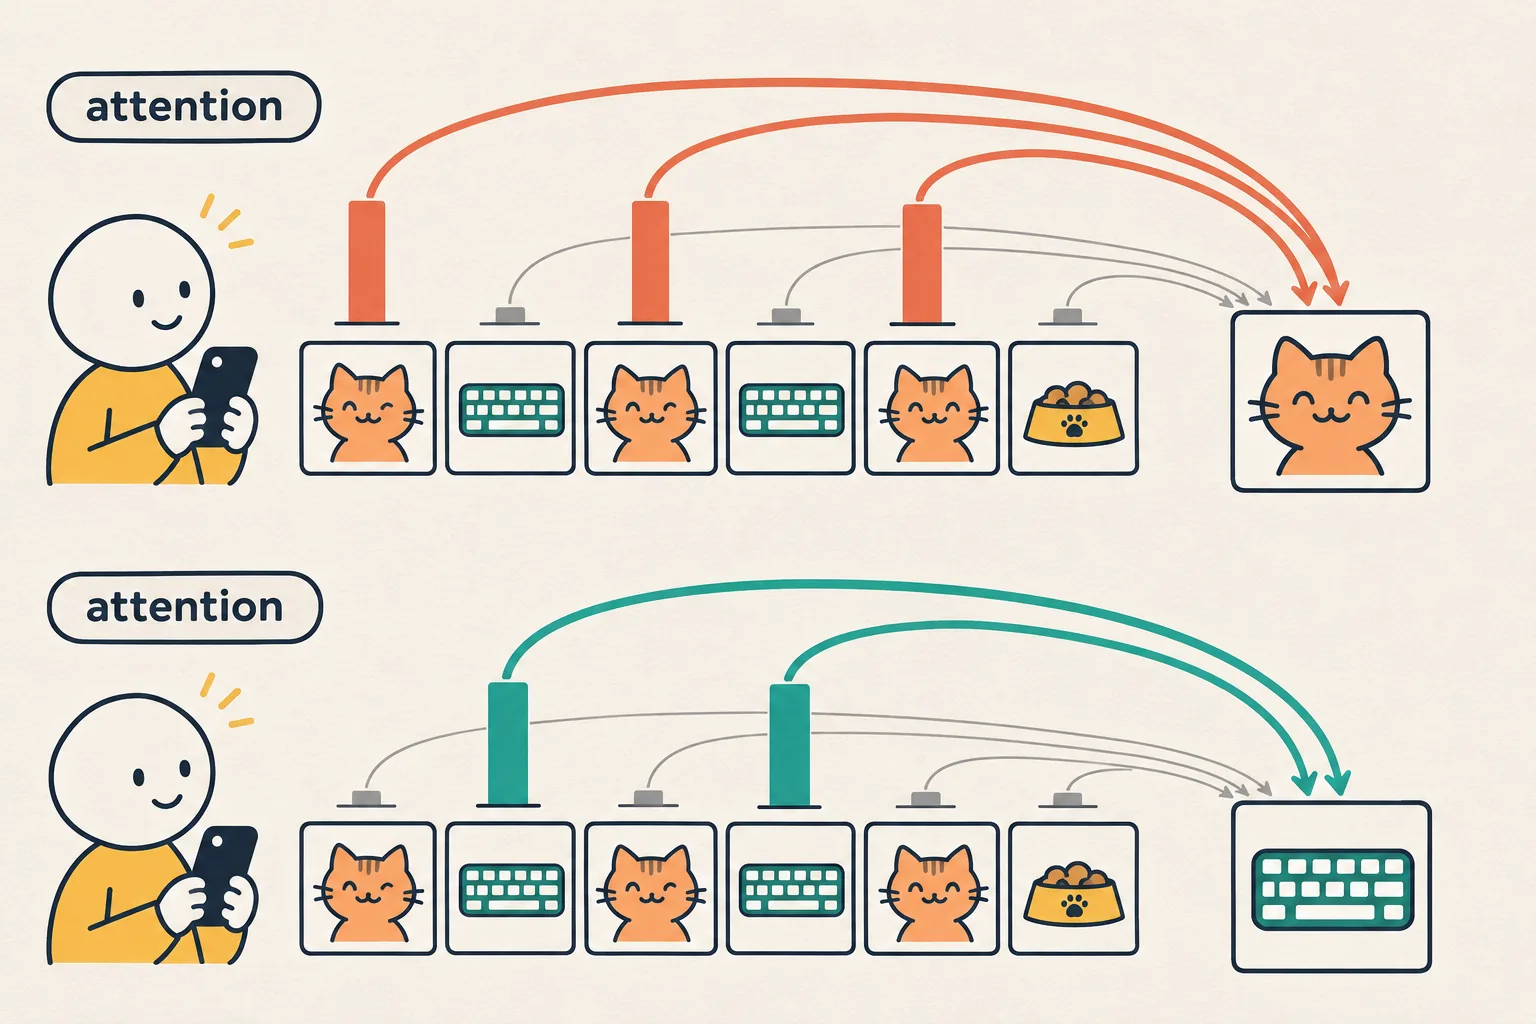
雙塔把小林最近 50 支影片一律取平均,不管評估的是什麼。DIN 則針對每個候選重新分配權重:評估貓影片時,主要參考他看過的貓;評估鍵盤影片時,主要參考他看過的 數位產品內容。這就是「注意力」。
精排一次預測三件事:會不會長時間播放、會不會看完、會不會按讚,再依權重合成一個分數:
排序分數 = 0.45 × P(長時間播放) + 0.30 × P(按讚) + 0.25 × P(看完)這組權重其實是產品決策:調高長時間播放,推薦出來的就更「讓人停不下來」;調高按讚,就更「討喜」。
重排最後看一整頁:同一個作者最多出現兩次、別連續出現三支同類影片、新影片加一點分。它一個位置、一個位置地選,每次都看前面已經放了什麼。最後傳給小林一頁十支。
插曲:滑到一支剛上傳的影片
第三頁裡,小林滑到一支一小時前才上傳的影片:一隻小貓第一次見到雪。他看完了,還按了讚。
這支影片在系統裡幾乎是一張白紙:大表裡它那一欄是空的,ItemCF 的相似清單裡沒有它,它的 ID 向量還是隨機初始化的值。那它是怎麼被推薦出來的,又是怎麼慢慢「認識自己」的?
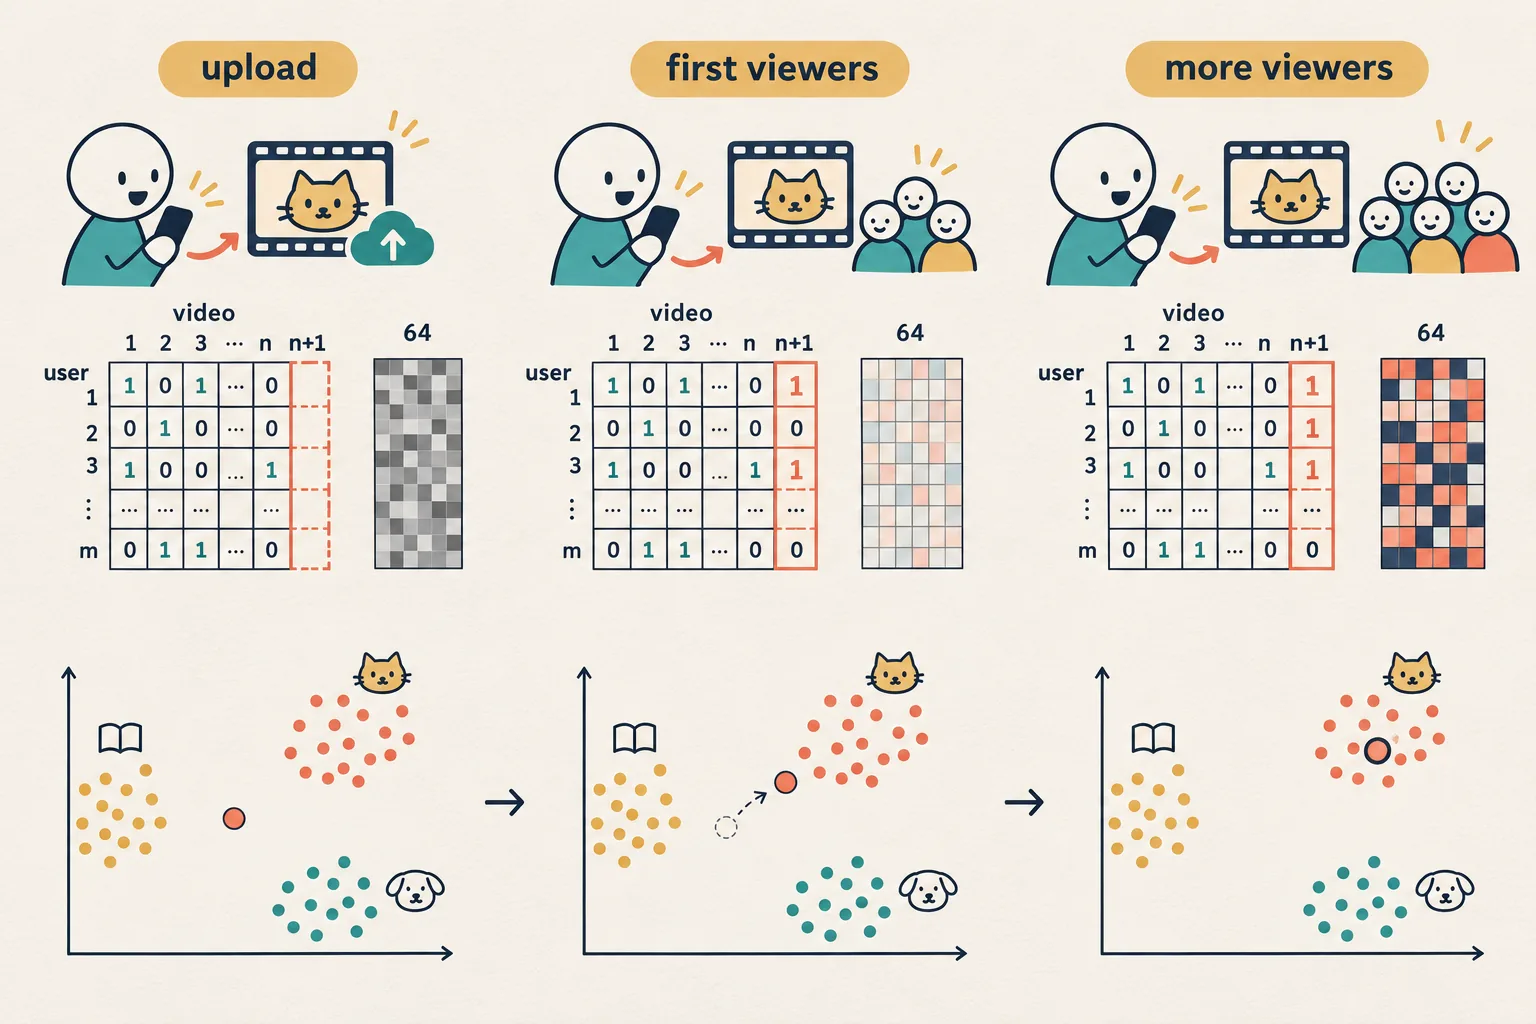
- 上傳時:先靠「它是什麼」。行為資料為零,但作者和標籤是有的。雙塔的影片塔本來就會輸入作者和標籤,所以它一上傳就能算出一個大致的向量:一個常發可愛寵物影片的作者、標籤是「萌寵」,向量自然落在貓影片附近。小林正是這樣透過雙塔召回看到它的。
- 第一批觀眾:用少量流量試水溫。平台通常會給新影片一小份基本曝光,先推薦給幾百位口味可能合得來的人。小林就是其中之一。
- 回饋累積起來。小林的「看完 + 按讚」和其他人的反應,會被寫進日誌。以幾分鐘為單位的串流運算,會先更新它的熱度;回饋好,就推薦給更多人,回饋差就停下來。
- 下一次訓練:真正被「認識」。定期重新訓練會用上這些新日誌:它那一欄的格子被填上了,ItemCF 替它算出了第一批相似影片,它的 ID 向量也被梯度拉向「被同一群人喜歡」的那群影片。從這時起,它不再只是「一個可愛寵物作者的影片」,而是「被這群愛貓的人看完的影片」。
這就是物品冷啟動。在我讀的這個專案裡,這部分其實沒做好:資料集只有一個月,候選裡幾乎沒有新影片,推薦仍然集中在熱門內容上。但思路是一樣的:先靠內容,再靠試水溫,最後靠行為。
為什麼越滑越懂你
把前面串起來,會發現有兩個轉速完全不同的循環:
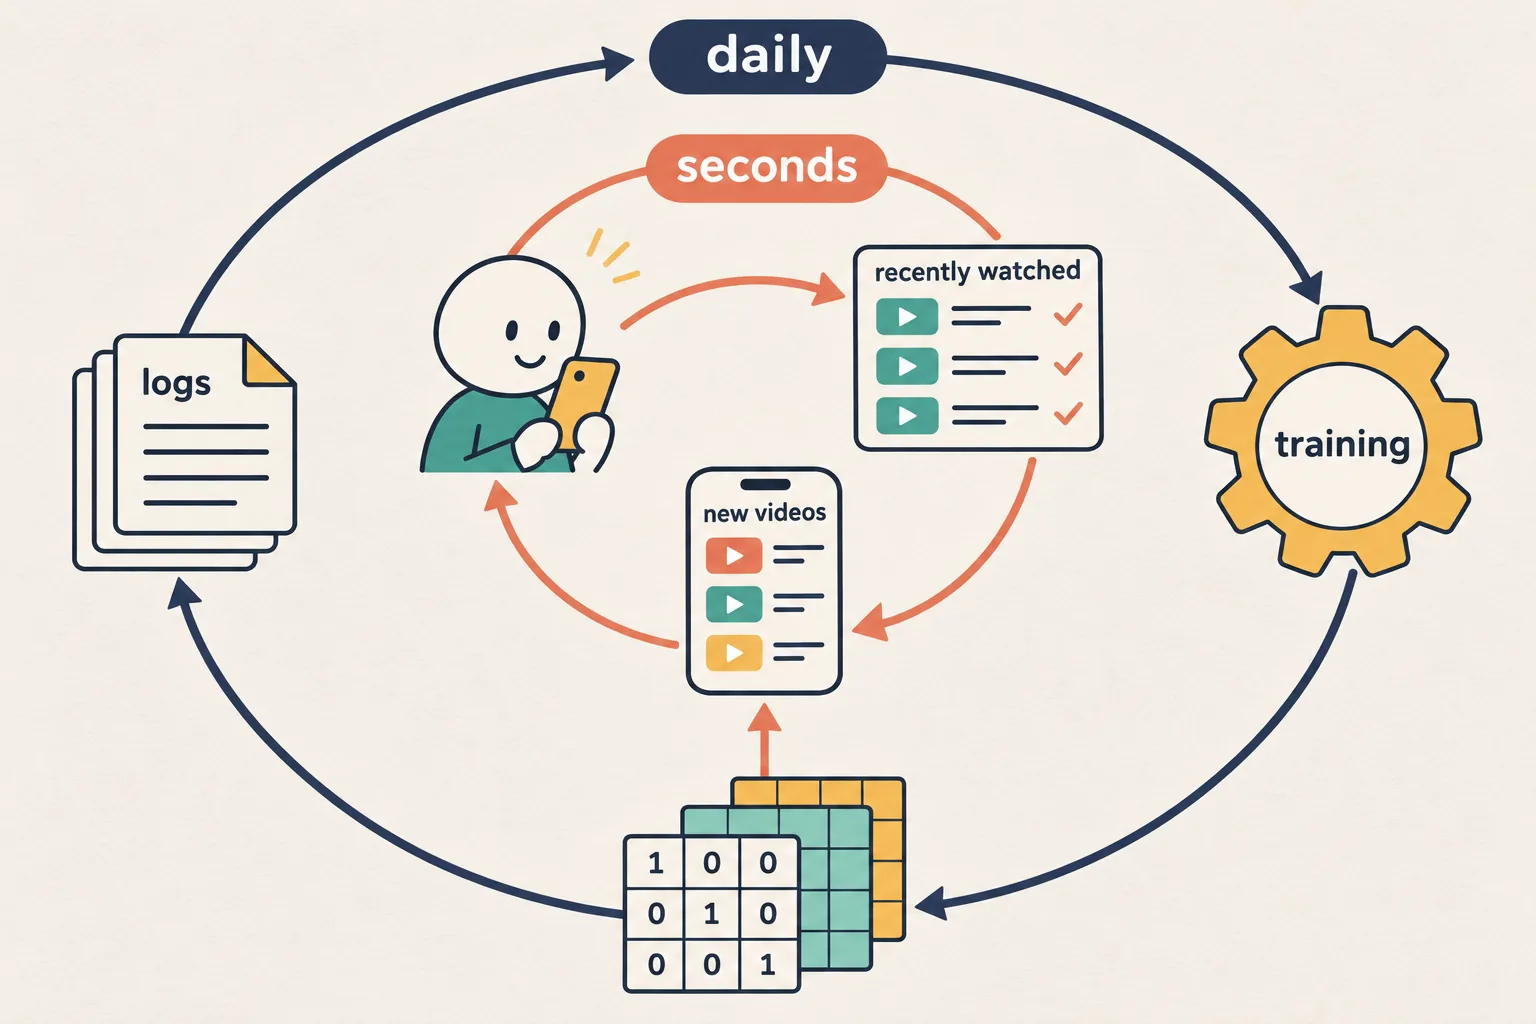
- 快循環(秒級):你的每次回饋立刻改變「近況」,下一頁的小林向量和精排的注意力都跟著變。模型一點也沒變,變的是輸入。你感受到的「它馬上就懂了」,大多來自這裡。
- 慢循環(天級):所有人的日誌累積起來,重新訓練模型、重算相似清單,新影片也是在這裡被真正認識的。
推得好不好,怎麼知道
最後說一個讓我意外的結果。專案做了一次離線 A/B:一組使用者只推薦熱門影片,一組用上面整個流程。在主要指標上,整個流程反而輸了 7.6%,不過信賴區間是 [−16.1%, +1.5%],統計上並不顯著。
原因很有意思:離線評估的「答案」,只來自快手當時真的推薦過的影片,而快手本身就偏好熱門內容。我們推薦一支小眾但很合口味的影片,如果快手當時沒推薦過,日誌裡就沒有使用者對它的反應,只能算沒命中。離線評估本來就會獎勵「和原來推薦得一樣」,懲罰個人化。這叫曝光偏差。所以離線指標只能參考,推薦演算法好不好,最後還是得靠線上 A/B 測試。
一句話總結
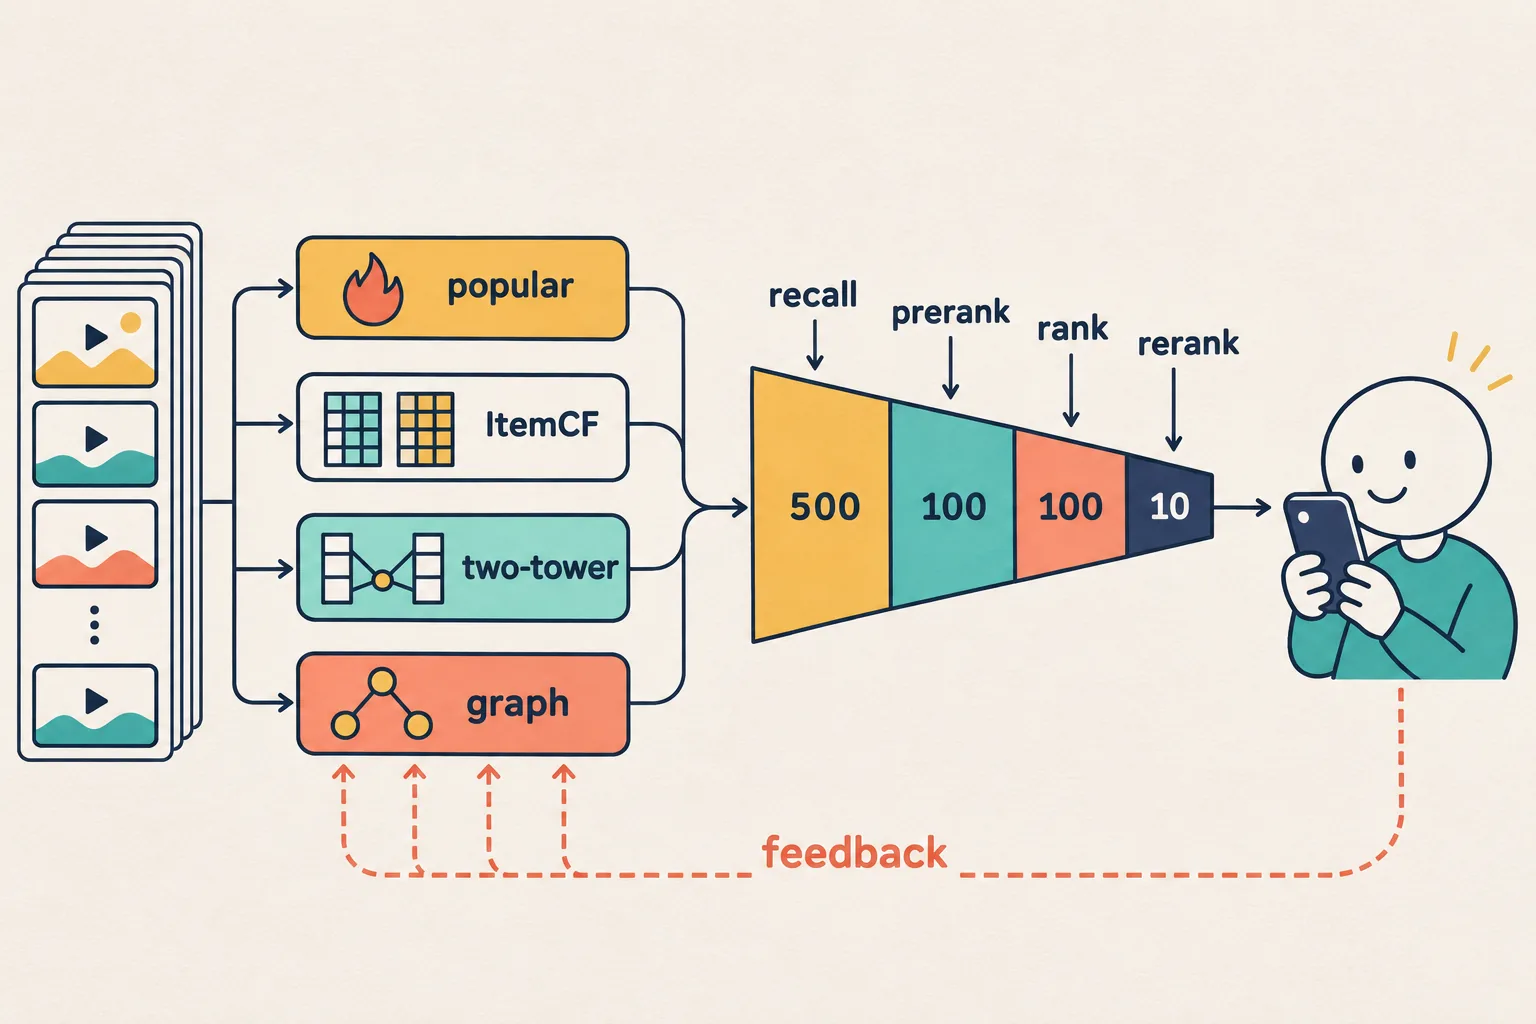
推薦系統是一個漏斗:召回決定能推薦什麼,排序決定先推薦什麼,重排決定一頁好不好看。離線把「影片和影片的關係」學好,線上只算「你此刻的近況」。所以它越滑越懂你,靠的不是每一秒都在重新學習,而是每一秒都在更新它眼裡的你。
想自己動手的話,可以 clone 上面那個儲存庫,資料集和訓練好的模型都提交在裡面(約 1.3 GB),每一層的指標和日誌都能直接看到。